Microsoft เผย AI วินิจฉัยเคสยากจำลองถูก 83% แพทย์ทั่วไป 36% แต่ไม่ได้เทียบแพทย์เฉพาะทาง
งานวิจัย Microsoft ใน Science พบระบบ AI วินิจฉัยเคสยากจำลองถูก 83% แพทย์ทั่วไป 36% แต่ไม่ได้เทียบแพทย์เฉพาะทาง และยังไม่ได้ทดสอบกับคนไข้จริง
สารบัญ (13 หัวข้อ)
- สรุปประเด็นสำคัญ
- MAI-DxO ทำงานอย่างไร
- ตัวเลขในงานวิจัยหมายถึงอะไร
- "แพทย์ทั่วไป" ในการทดสอบคือใคร
- ความแม่นมาจาก Microsoft หรือจากโมเดลข้างใต้
- ถูกกว่าหมอจริงไหม
- ต่างจากข่าวเดียวกันเมื่อปี 2025 อย่างไร
- แพทย์นอก Microsoft ว่าอย่างไร
- ใช้ได้ในไทยไหม และเกี่ยวกับ Copilot หรือเปล่า
- ขั้นต่อไป: ทดสอบกับคนไข้จริง
- ความน่าเชื่อถือของผลวัด
- สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- บทวิเคราะห์จาก ReadEval
ลองนึกภาพห้องประชุมของทีมหมอ คนหนึ่งเสนอว่าคนไข้น่าจะเป็นโรคอะไร อีกคนเลือกว่าควรส่งตรวจอะไรต่อ อีกคนคอยค้านว่าทีมอาจคิดผิด และอีกคนคอยเบรกเมื่อค่าตรวจแพงเกินจำเป็น Microsoft จำลองการประชุมแบบนี้ขึ้นในคอมพิวเตอร์ โดยให้ AI สวมบทหมอทุกคน แล้วตั้งชื่อว่า MAI-DxO งานวิจัยที่เพิ่งตีพิมพ์ในวารสาร Science รายงานว่าระบบนี้วินิจฉัยเคสยากได้ถูกบ่อยกว่าแพทย์ทั่วไปเกินสองเท่า
การทดสอบนี้ไม่ได้ใช้คนไข้จริง ทีมวิจัยนำเคสวินิจฉัยยากที่วารสารการแพทย์ NEJM เคยตีพิมพ์มาทำเป็นเกมถามตอบ ผู้เล่นเริ่มจากข้อมูลสั้น ๆ แล้วต้องถามอาการหรือสั่งตรวจทีละอย่าง โดยมี AI อีกตัวเป็น "ผู้เฝ้าประตู" ที่เปิดข้อมูลให้เฉพาะเรื่องที่ถูกถาม และทุกการตรวจมีราคา คล้ายเกมนักสืบที่ต้องจ่ายเงินซื้อเบาะแส ต่างจากห้องตรวจจริงตรงที่ทุกอย่างเป็นตัวหนังสือ ไม่มีการตรวจร่างกาย และเคสถูกคัดมาเพราะยากเป็นพิเศษ ไม่มีคนไข้ที่ป่วยเล็กน้อยหรือไม่ได้ป่วยปนอยู่เลย
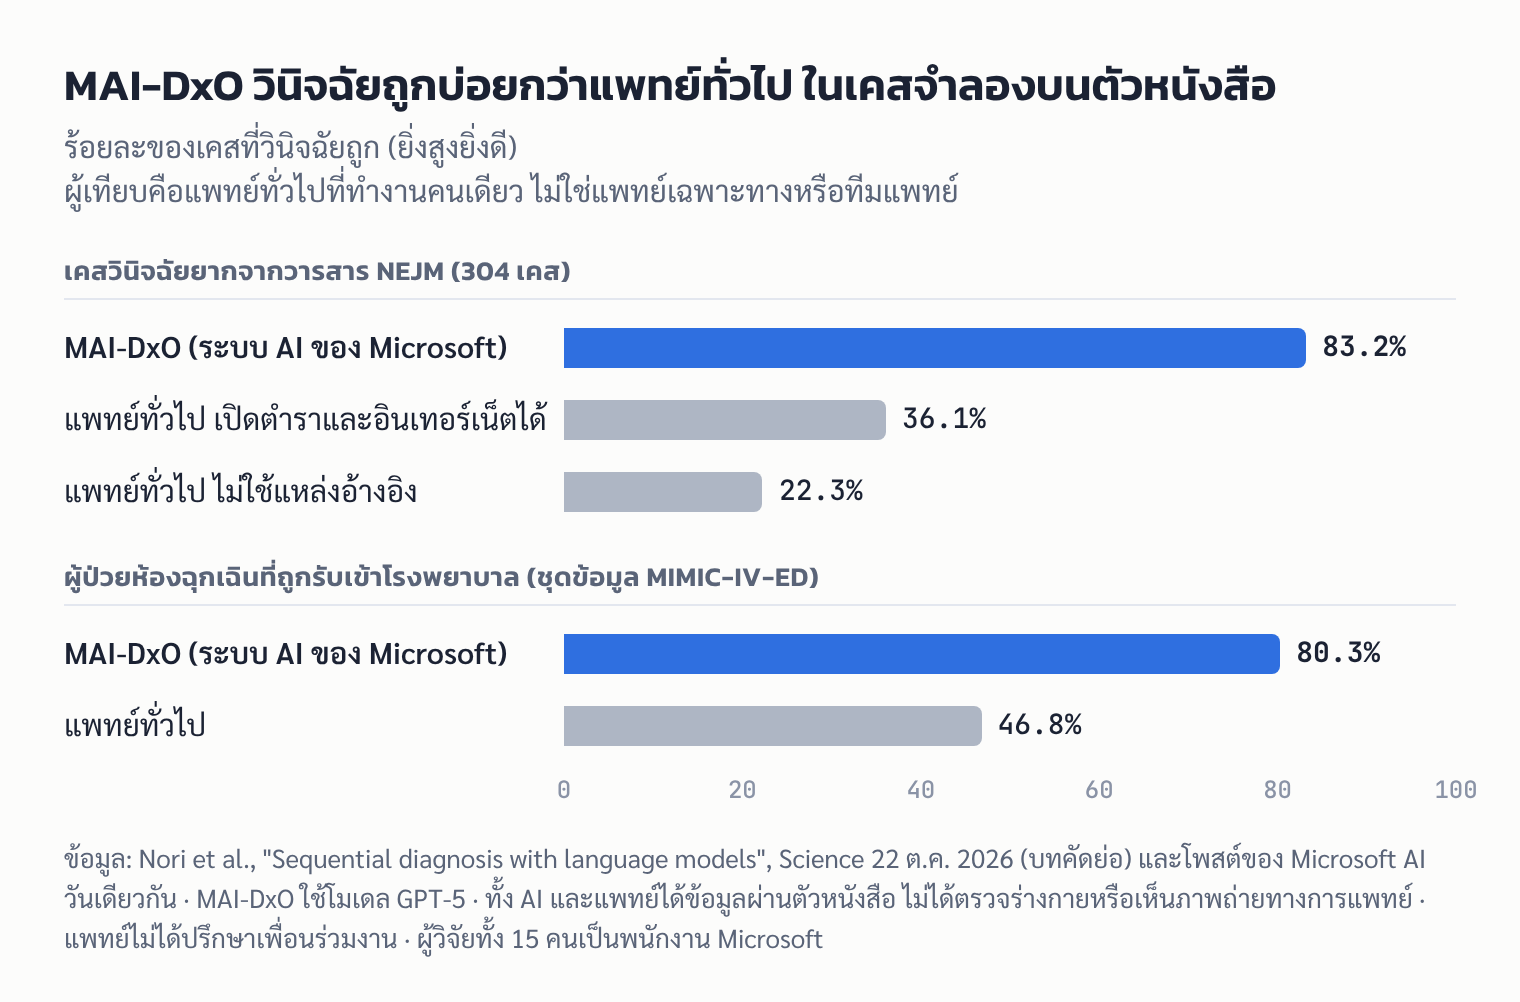
ผลคือ MAI-DxO ตอบถูก 83% ขณะที่แพทย์ทั่วไปที่เปิดตำราและอินเทอร์เน็ตได้ตอบถูก 36% หรือราว 1 ใน 3 ปัญหาคือผู้ที่ถูกนำมาเทียบเป็นแพทย์เวชปฏิบัติทั่วไปและอายุรแพทย์ทั่วไปที่ทำงานคนเดียว ไม่ใช่แพทย์เฉพาะทางหรือทีมแพทย์ที่ปกติรับเคสระดับนี้ และ TechCrunch ชี้ว่าความแม่นส่วนใหญ่มาจากโมเดล GPT-5 ของ OpenAI ที่อยู่ข้างใต้ ระบบของ Microsoft เพิ่มให้อีกราว 4 จุด แต่ Mustafa Suleyman ซีอีโอ Microsoft AI ก็เรียกผลนี้ว่าก้าวสู่ "medical superintelligence" หรือ AI การแพทย์ที่เก่งเกินมนุษย์
สิ่งที่ควรรู้คือ MAI-DxO ยังเป็นงานวิจัย ไม่ใช่ฟีเจอร์ในแอป Copilot หรือแชตบอตตัวไหน ผู้วิจัยทุกคนเป็นพนักงาน Microsoft และด่านที่สำคัญที่สุดยังมาไม่ถึง คือการทดสอบกับคนไข้จริงที่ยินยอมเข้าร่วม ในโรงพยาบาล Beth Israel Deaconess ที่บอสตัน สหรัฐฯ
ครั้งหน้าที่คุณเห็นข่าว "AI เก่งกว่าหมอ" ลองถามสามข้อ เทียบกับหมอแบบไหน ใช้เคสแบบไหน และทดสอบกับคนไข้จริงหรือยัง ถ้าคุณมีอาการเจ็บป่วย ทางที่ถูกยังคือไปพบแพทย์ วิธีทดสอบ ตัวเลขทั้งหมด ความเห็นแพทย์นอก Microsoft และคะแนนความน่าเชื่อถืออยู่ด้านล่าง
สรุปประเด็นสำคัญ
- งานวิจัย: "Sequential diagnosis with language models" ตีพิมพ์ใน Science เมื่อ 22 ต.ค. 2026 (เล่ม 394 ฉบับ 6822) ผู้เขียน 15 คนสังกัด Microsoft ทั้งหมด รวมถึง Mustafa Suleyman และ Dominic King รองประธานฝ่ายสุขภาพของ Microsoft AI
- ผล: บนเคสยาก 304 เคสจาก NEJM ระบบ MAI-DxO ตอบถูก 83.2% แพทย์ทั่วไปตอบถูก 36.1% เมื่อเปิดตำราและอินเทอร์เน็ตได้ และ 22.3% เมื่อไม่ใช้แหล่งอ้างอิง ส่วนเคสผู้ป่วยห้องฉุกเฉิน ระบบตอบถูก 80.3% แพทย์ 46.8%
- ข้อจำกัด: เป็นการทดสอบบนตัวหนังสือจากเคสในอดีต เทียบกับแพทย์ทั่วไปที่ทำงานคนเดียว ไม่ใช่แพทย์เฉพาะทาง และบทคัดย่อของงานเองระบุว่าผลได้มา "ในสภาพแวดล้อมการทดสอบที่ควบคุมไว้"
- ใช้ได้ไหม: MAI-DxO ไม่ได้อยู่ใน Copilot และไม่มีผลิตภัณฑ์ให้คนทั่วไปใช้ ขั้นต่อไปคือการทดสอบกับคนไข้จริงที่บอสตัน
- ความน่าเชื่อถือ: 🔴 คำกล่าวอ้าง (2 จาก 6 ข้อตามเกณฑ์ของ ReadEval) แม้ผ่านการตีพิมพ์ในวารสารและบอกข้อจำกัดชัด แต่ผู้วัดคือ Microsoft เอง ตัวระบบ MAI-DxO ไม่ได้เปิดให้คนนอกรันซ้ำ และกลุ่มที่นำมาเทียบไม่ใช่ผู้เชี่ยวชาญที่ปกติรับเคสระดับนี้ จึงยังเป็นคำกล่าวอ้างของผู้พัฒนาที่ยังไม่มีผลวัดอิสระ
MAI-DxO ทำงานอย่างไร
Microsoft เรียกทั้งงานนี้ว่าการวินิจฉัยแบบทีละขั้น (sequential diagnosis) ซึ่งต่างจากข้อสอบใบอนุญาตแพทย์ที่ให้ข้อมูลครบแล้วเลือกคำตอบ โพสต์ของ Microsoft AI ระบุว่าข้อสอบแบบนั้น "ออกแบบมาวัดความรู้ของแพทย์ ไม่ใช่ความเป็นจริงของการวินิจฉัยโรค" การทดสอบชุดใหม่จึงมีสามบทบาท
- ผู้วินิจฉัย คือระบบ AI หรือแพทย์ที่ถูกทดสอบ ได้รับสรุปเคสสั้น ๆ ที่ไม่บอกคำตอบ แล้วเลือกว่าจะถามคำถาม สั่งตรวจ หรือฟันธงการวินิจฉัย
- ผู้เฝ้าประตู (gatekeeper) เป็นโมเดล AI ที่ตอบจากเนื้อหาเต็มของเคส ถ้าเคสมีผลตรวจนั้นจะส่งผลจริงให้ ถ้าไม่มีจะสร้างผลตรวจสมมุติที่สอดคล้องกับเคส เอกสารฉบับปี 2025 อธิบายว่าทำแบบนี้เพราะการตอบว่า "ไม่มีข้อมูล" จะกลายเป็นคำใบ้ว่ากำลังถามผิดทาง
- ผู้ตัดสิน (judge) เป็นโมเดล AI ที่ให้คะแนนคำวินิจฉัยเทียบกับคำตอบจริง 1–5 คะแนน ได้ 4–5 ถือว่าถูก
ในเอกสารฉบับปี 2025 ทีมวิจัยอธิบายว่า MAI-DxO ให้โมเดลภาษา "ตัวเดียว" สวมบทหมอ 5 คน ได้แก่ Dr. Hypothesis ที่จัดอันดับโรคที่น่าจะเป็น Dr. Test-Chooser ที่เลือกการตรวจไม่เกินสามอย่างต่อรอบ Dr. Challenger ที่ทำหน้าที่ค้านเพื่อกันการยึดติดกับคำตอบแรก Dr. Stewardship ที่คุมค่าใช้จ่าย และ Dr. Checklist ที่ตรวจความเรียบร้อย ทั้งห้าบทถกกันหลายรอบก่อนตัดสินใจ ดังนั้นภาพ "AI หลายตัวทำงานเป็นทีม" ที่บางสื่อใช้จึงไม่ตรงนัก ที่ถูกกว่าคือโมเดลเดียวเล่นหลายบทบาท ส่วนโพสต์ของ Microsoft ปีนี้เรียกว่า "คณะแพทย์เสมือน" โดยไม่ได้แจกแจงบทบาทใหม่
MAI-DxO ไม่ผูกกับโมเดลค่ายใด TechCrunch รายงานว่า Microsoft ทดลองกับโมเดลของ OpenAI, Google, Anthropic, Meta และ DeepSeek และได้ผลดีที่สุดกับ GPT-5 และ GPT-5.5 ของ OpenAI
ตัวเลขในงานวิจัยหมายถึงอะไร
| ชุดเคส | ผู้วินิจฉัย | ตอบถูก |
|---|---|---|
| เคสยากจาก NEJM (304 เคส) | MAI-DxO บน GPT-5 | 83.2% |
| เคสยากจาก NEJM | แพทย์ทั่วไป เปิดตำราและอินเทอร์เน็ตได้ | 36.1% |
| เคสยากจาก NEJM | แพทย์ทั่วไป ไม่ใช้แหล่งอ้างอิง | 22.3% |
| ผู้ป่วยห้องฉุกเฉินที่ถูกรับเข้าโรงพยาบาล (MIMIC-IV-ED 325 เคส) | MAI-DxO บน GPT-5 | 80.3% |
| ผู้ป่วยห้องฉุกเฉินที่ถูกรับเข้าโรงพยาบาล | แพทย์ทั่วไป | 46.8% |
ตัวเลข 83.2%, 80.3%, 36.1% และ 46.8% มาจากบทคัดย่อของงานใน Science ส่วน 22.3% และจำนวนเคสห้องฉุกเฉินมาจากโพสต์ของ Microsoft และรายงานของ The Next Web กับ Unite.AI
เคส NEJM คืออะไร คือรายงานเคสชุด Case Records of the Massachusetts General Hospital ที่วารสาร NEJM ตีพิมพ์เป็นประจำ แต่ละเคสถูกเลือกเพราะวินิจฉัยยากและใช้สอนแพทย์ จึงเป็นเคสจริงในอดีต แต่การ "พบคนไข้" ในการทดสอบเป็นแบบจำลองบนตัวหนังสือ
ชุดห้องฉุกเฉินเพิ่มอะไร ชุด MIMIC-IV-ED เป็นข้อมูลผู้ป่วยจริงที่ลบข้อมูลระบุตัวตนแล้ว หน้าเว็บของ SDBench บอกว่ารูปแบบใกล้กับสรุปการจำหน่ายผู้ป่วย และ Microsoft เรียกว่าเป็นอาการแบบที่พบทั่วไปในห้องฉุกเฉินของสหรัฐฯ ชุดนี้จึงตอบข้อวิจารณ์เรื่อง "มีแต่เคสยาก" ได้บางส่วน แต่ก็ยังเป็นเคสในอดีตบนตัวหนังสือเช่นกัน
"แพทย์ทั่วไป" ในการทดสอบคือใคร
บทคัดย่อของงานใน Science เรียกกลุ่มนี้ว่า generalist physicians ส่วน TechCrunch อธิบายว่าเป็นแพทย์เวชปฏิบัติทั่วไปและอายุรแพทย์ทั่วไปที่ทำงานคนเดียว แต่ละคนไม่ได้ปรึกษาเพื่อนร่วมงาน และ The Next Web ระบุว่าทั้งแพทย์และ AI ไม่ได้ตรวจร่างกายหรือดูภาพถ่ายทางการแพทย์ด้วยตัวเอง
TechCrunch ชี้ว่าแพทย์เฉพาะทางและทีมแพทย์ ซึ่งปกติเป็นผู้รับเคสที่ซับซ้อนระดับนี้ ไม่ได้อยู่ในการเปรียบเทียบเลย พูดง่าย ๆ คือผลนี้บอกว่า AI ทำได้ดีกว่าแพทย์ทั่วไปที่ต้องแก้โจทย์ยากคนเดียว แต่ไม่ได้บอกว่าเก่งกว่าผู้เชี่ยวชาญ หรือเก่งกว่าระบบโรงพยาบาลที่แพทย์ทำงานร่วมกัน
ReadEval ยังไม่เห็นจำนวนแพทย์ที่ร่วมการทดสอบในฉบับ Science เพราะเปิดบทความฉบับเต็มไม่ได้ Unite.AI รายงานว่าแพทย์ทำเคสชุดย่อย 56 เคสที่กันไว้สำหรับทดสอบ ส่วนฉบับปี 2025 ใช้แพทย์ 21 คนในสหรัฐฯ และสหราชอาณาจักร เป็นแพทย์เวชปฏิบัติทั่วไป 17 คนและแพทย์ทั่วไปในโรงพยาบาล 4 คน ประสบการณ์มัธยฐาน 12 ปี
ความแม่นมาจาก Microsoft หรือจากโมเดลข้างใต้
ข้อนี้คือจุดที่ TechCrunch ขุดจากข้อมูลในงานวิจัยเอง
- GPT-5 ตัวเปล่า ที่ใช้คำสั่งพื้นฐานสั้น ๆ ตอบเคส NEJM ถูก 78.9% ด้วยค่าตรวจประมาณ 8,400 ดอลลาร์ต่อเคส เมื่อใส่ MAI-DxO ความแม่นเพิ่มราว 4 จุด และค่าตรวจลดลงราว 3,000 ดอลลาร์
- GPT-5.5 ซึ่งเปิดตัวเมื่อเมษายน 2026 ตอบเคสยากได้ราว 72% เมื่อใช้ตัวเดียว และเกือบ 87% เมื่อใช้กับ MAI-DxO ด้วยค่าใช้จ่ายต่ำลงเล็กน้อย
- เคสห้องฉุกเฉิน MAI-DxO แทบไม่ช่วยเรื่องความแม่นหรือค่าใช้จ่าย GPT-5.5 ทำได้ราว 85% ทั้งแบบมีและไม่มี MAI-DxO
- โมเดลที่อ่อนกว่า ได้ประโยชน์มากกว่า Gemini 2.5 Flash ขึ้นจาก 46.4% เป็นเกือบ 69% แต่ช่องว่างระหว่างโมเดลอ่อนกับโมเดลแรงยังกว้างกว่าส่วนที่ MAI-DxO เพิ่มให้
TechCrunch สรุปว่าส่วนใหญ่ของการพัฒนามาจากตัวโมเดล และทีมของ Microsoft เองก็ระบุว่าส่วนที่เพิ่มขึ้นจะหดลงเมื่อโมเดลเข้าใกล้เพดานสูงสุดที่เป็นไปได้
ถูกกว่าหมอจริงไหม
Microsoft บอกว่าไม่มีวิธีอื่นทั้งของคนและ AI ที่ทั้งแม่นกว่าและถูกกว่า MAI-DxO บนทั้งสองชุดเคส และรุ่นที่ตั้งให้ประหยัดได้ความแม่น 81% ด้วยค่าใช้จ่าย "ไม่ถึงครึ่ง" ของระบบที่เทียบด้วย
ตัวเลขที่ Unite.AI ดึงจากงานวิจัยช่วยให้เห็นภาพชัดขึ้น บนเคส NEJM แพทย์ที่เปิดตำราได้ใช้ค่าตรวจเฉลี่ย 4,725 ดอลลาร์ต่อเคส ส่วน MAI-DxO แบบไม่จำกัดงบใช้ 5,431 ดอลลาร์ ซึ่งแพงกว่าแพทย์ ขณะที่แบบจำกัดงบได้ 80.9% ด้วยค่าใช้จ่าย 2,241 ดอลลาร์ แปลว่าคำว่า "ถูกกว่า" ขึ้นกับว่าตั้งค่าระบบแบบไหน
ควรรู้ด้วยว่าค่าใช้จ่ายทั้งหมดเป็นการประเมินจากราคาค่าตรวจในสหรัฐฯ ไม่ใช่บิลจริง ตามที่ The Next Web ระบุ และฉบับปี 2025 ยอมรับเองว่าค่าใช้จ่ายไม่ได้สะท้อนเรื่องอื่นที่สำคัญกับคนไข้ เช่น ความเจ็บตัวจากการตรวจ ความเสี่ยง และเวลารอผล
ต่างจากข่าวเดียวกันเมื่อปี 2025 อย่างไร
MAI-DxO ไม่ใช่เรื่องใหม่ทั้งหมด Microsoft เปิดตัวครั้งแรกเมื่อ 30 มิ.ย. 2025 พร้อมเอกสารบน arXiv ที่ยังไม่ผ่านการตรวจโดยผู้ทรงคุณวุฒิ ตอนนั้นระบบใช้โมเดล o3 ของ OpenAI ตอบถูก 80% เทียบกับแพทย์ 20% หรือ "สี่เท่า" และสูงสุด 85.5% เมื่อตั้งค่าให้เน้นความแม่น
ข้อวิจารณ์หลักในปีนั้นคือแพทย์ถูกห้ามใช้เครื่องมือค้นหา แชตบอต AI และแหล่งข้อมูลการแพทย์ออนไลน์ ทีมวิจัยให้เหตุผลว่าเคส NEJM หาอ่านได้บนอินเทอร์เน็ต จึงกันไม่ให้แพทย์ค้นเจอคำตอบตรง ๆ และยอมรับเองว่าไม่ตรงกับการทำงานจริง ฉบับ Science ปีนี้เพิ่มกลุ่มแพทย์ที่เปิดตำราและอินเทอร์เน็ตได้ ซึ่งตอบถูก 36.1% และเพิ่มชุดเคสห้องฉุกเฉินเข้ามา ช่องว่างระหว่าง AI กับแพทย์จึงแคบลงจาก "สี่เท่า" เหลือราว "สองเท่า" แต่ก็ยังกว้าง
แพทย์นอก Microsoft ว่าอย่างไร
ในข่าวที่ ReadEval อ่าน ทั้ง TechCrunch, The Next Web และ Unite.AI ไม่มีความเห็นจากแพทย์หรือนักวิจัยนอก Microsoft ต่อฉบับ Science ปีนี้ ความเห็นอิสระที่หาได้เป็นความเห็นต่อฉบับปี 2025 ซึ่งใช้วิธีทดสอบเดียวกัน นิตยสาร TIME สัมภาษณ์ไว้ 2 คน
- Keith Dreyer ประธานเจ้าหน้าที่ฝ่ายวิทยาการข้อมูลของ Massachusetts General Hospital และ Brigham and Women's Hospital มองว่างานนี้ไม่ได้ทดสอบโมเดลที่ถูกปรับมาเพื่องานการแพทย์โดยเฉพาะ แต่ทดสอบแนวคิดการนำโมเดลที่มีอยู่มารวมการตัดสินใจกัน ซึ่ง "ไม่ได้น่าแปลกใจ" สำหรับเขา และชี้ว่าผลแบบนี้ไม่ได้ทำให้ระบบเข้าใกล้การรับรองจาก FDA เพราะ FDA ยังไม่ได้บอกว่าระบบแบบนี้นับเป็นเครื่องมือแพทย์หรือไม่
- Eric Topol ผู้ก่อตั้ง Scripps Research Translational Institute ชมว่าความแม่นที่เพิ่มขึ้นมากกว่างานก่อน ๆ และถูกกว่ามาก แต่บอกว่า "มันไม่เปลี่ยนเวชปฏิบัติ จนกว่าจะนำไปใช้บนถนนจริงของการแพทย์" หมายถึงต้องทดลองกับคนไข้จริงหลายระบบสุขภาพ ควรรู้ด้วยว่าเอกสารฉบับปี 2025 ระบุชื่อ Topol อยู่ในรายชื่อผู้ที่ทีมวิจัยขอบคุณที่ให้ความเห็น เขาจึงไม่ได้อยู่ห่างจากงานนี้เสียทีเดียว
ทั้งสองคนพูดตรงกันในประเด็นหลัก คือการทดสอบบนเคสในอดีตยังไม่ใช่หลักฐานว่าระบบช่วยคนไข้จริงได้
ใช้ได้ในไทยไหม และเกี่ยวกับ Copilot หรือเปล่า
- MAI-DxO ไม่มีให้ใช้ที่ไหนเลยตอนนี้ ทั้งในไทยและในสหรัฐฯ โพสต์ของ Microsoft ไม่ได้ระบุว่าจะนำไปทำผลิตภัณฑ์เมื่อไร
- ไม่ได้อยู่ใน Copilot Microsoft มีฟีเจอร์ชื่อ Copilot Health ที่เปิดตัวเมื่อ 12 มี.ค. 2026 แต่หน้าประกาศของมันพูดถึง MAI-DxO ในฐานะงานวิจัยที่ "ได้ผลน่าประทับใจ" ไม่ใช่ส่วนหนึ่งของฟีเจอร์ Copilot Health เองก็เปิดให้เฉพาะผู้ใหญ่อายุ 18 ปีขึ้นไปในสหรัฐฯ เป็นภาษาอังกฤษ และระบุชัดว่า "ไม่ได้มีไว้เพื่อวินิจฉัย รักษา หรือป้องกันโรค" และ "ไม่ได้แทนที่แพทย์ของคุณ"
- แชตบอตทั่วไปไม่ใช่ MAI-DxO การพิมพ์อาการถาม Copilot, ChatGPT หรือ Gemini ไม่ได้ผ่านกระบวนการทีละขั้นแบบในงานวิจัยนี้ และผลในงานนี้ไม่ได้บอกอะไรเกี่ยวกับความแม่นของแชตบอตเหล่านั้น
- ส่วนที่เปิดให้คนนอกใช้ คือชุดทดสอบ SDBench ที่ Microsoft เปิดโค้ดไว้บน GitHub สำหรับนักวิจัย ใช้วัดระบบ AI ของตัวเองได้ แต่ข้อมูลเคส NEJM ต้องขออนุญาตจาก NEJM และข้อมูลห้องฉุกเฉินต้องผ่านการรับรองสิทธิ์บน PhysioNet ส่วนในชุดโค้ดมีเพียงตัววินิจฉัยพื้นฐาน ไม่มีตัว MAI-DxO
ขั้นต่อไป: ทดสอบกับคนไข้จริง
Microsoft จับมือกับ Beth Israel Deaconess Medical Center ในบอสตัน ทำการศึกษาไปข้างหน้า (prospective study) โพสต์ของ Microsoft ระบุว่าคนไข้จะ "คุยกับระบบโดยตรง" แล้วนำผลไปเทียบกับการประเมินของแพทย์ที่ทำแยกกัน TechCrunch รายงานว่าคนไข้ที่ยินยอมจะได้รับการดูแลตามปกติ ควบคู่กับคำแนะนำของระบบ และจะทดสอบในห้องฉุกเฉินและคลินิกเร่งด่วน ยังไม่มีการเปิดเผยจำนวนคนไข้หรือวันเริ่ม
นอกจากนี้ TechCrunch รายงานว่า Microsoft กำลังร่วมกับ Mayo Clinic สร้างโมเดลพื้นฐานด้านการแพทย์ที่วางแผนเปิดตัวปีหน้า ซึ่งเป็นคนละโครงการกับ MAI-DxO และ Suleyman คาดว่า AI ด้านสุขภาพจะดีขึ้นในระดับ "order of magnitude" หรือราวสิบเท่า ภายใน 24–36 เดือน
ความน่าเชื่อถือของผลวัด
| เกณฑ์ | ผล | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | เปิดโค้ดชุดทดสอบ SDBench และค่าตั้งที่ใช้ในงาน Science แต่ตัว MAI-DxO ไม่ได้อยู่ในชุดโค้ด และข้อมูลเคสต้องขออนุญาตแยก คนนอกจึงรันซ้ำผลหลักเองไม่ได้ |
| บอกสภาพแวดล้อมครบ | ผ่าน | ระบุโมเดลที่ใช้ (GPT-5, GPT-5.5 และโมเดลอื่น) และล็อกโมเดลผู้เฝ้าประตูกับผู้ตัดสินไว้ในค่าตั้งของชุดทดสอบ |
| วัดหลายรอบและบอกความแปรปรวน | ไม่ผ่าน | ฉบับปี 2025 รายงานการทดสอบนัยสำคัญทางสถิติ และงานผ่านการตรวจของวารสาร แต่ ReadEval เปิดฉบับเต็มใน Science ไม่ได้ จึงตรวจตัวเลขความแปรปรวนของผลหลักเองไม่ได้ |
| เทียบอย่างยุติธรรม | ไม่ผ่าน | เทียบกับแพทย์ทั่วไปที่ทำงานคนเดียว ไม่ใช่แพทย์เฉพาะทางหรือทีมแพทย์ และทดสอบบนตัวหนังสือจากเคสที่คัดมาเพราะยาก |
| เป็นอิสระ | ไม่ผ่าน | ผู้เขียนทั้ง 15 คนเป็นพนักงาน Microsoft ซึ่งพัฒนาระบบที่ชนะ ยังไม่มีบุคคลที่สามทดสอบซ้ำ |
| ยอมรับข้อจำกัด | ผ่าน | บทคัดย่อระบุว่าเป็น "สภาพแวดล้อมการทดสอบที่ควบคุมไว้" และ Microsoft เขียนว่า "การทดสอบที่แท้จริงคือผลงานในสภาพแวดล้อมทางคลินิกจริง" |
รวม 2 จาก 6 ข้อ ป้าย 🔴 คำกล่าวอ้าง ใช้เป็นหลักฐานได้ว่าโมเดล AI รุ่นใหม่ทำโจทย์วินิจฉัยแบบทีละขั้นบนตัวหนังสือได้ดี แต่ยังไม่ใช่หลักฐานว่าเก่งกว่าหมอในการรักษาคนไข้จริง และเพราะเป็นการวัดของ Microsoft เองที่คนนอกยังรันซ้ำไม่ได้และยังไม่มีบุคคลที่สามตรวจซ้ำ ReadEval จึงจัดเป็นคำกล่าวอ้างของผู้พัฒนาจนกว่าจะมีการตรวจอิสระ
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- AI กี่ตัว: หลายสื่อเรียก MAI-DxO ว่า "AI หลายตัวทำงานเป็นทีม" แต่เอกสารฉบับปี 2025 อธิบายว่าเป็นโมเดลตัวเดียวสวมหลายบทบาท ส่วนความเห็นของ Keith Dreyer ใน TIME ที่ว่าเป็นการ "รวมการตัดสินใจของโมเดล" ก็ใช้ภาพแบบหลายโมเดลเช่นกัน ReadEval ยึดคำอธิบายของทีมวิจัย
- ตัวเลขแพทย์: บางสื่อใช้ 36% บางสื่อใช้ 22% หรือ "22–36%" ทั้งสองถูก เพราะมาจากแพทย์คนละเงื่อนไข (เปิดตำราได้และไม่ได้) ข่าวนี้ใช้ 36% เป็นหลักเพราะใกล้การทำงานจริงกว่า และเป็นตัวเลขที่บทคัดย่อเลือกใช้
- "สองเท่า" หรือ "สี่เท่า": ตัวเลข "สี่เท่า" มาจากฉบับปี 2025 ที่แพทย์ห้ามใช้แหล่งอ้างอิง ฉบับ Science ปีนี้เทียบกับแพทย์ที่เปิดตำราได้แล้วเหลือราวสองเท่า
- สถานที่ทดสอบที่บอสตัน: TechCrunch บอกว่าจะทดสอบในห้องฉุกเฉินและคลินิกเร่งด่วน The Next Web บอกว่าเน้นการคัดกรองคนไข้ในห้องรอของห้องฉุกเฉิน ส่วน Microsoft บอกเพียงว่าคนไข้จะคุยกับระบบโดยตรง
- ค่าใช้จ่าย: Microsoft เน้นว่าถูกกว่า แต่ตัวเลขที่ Unite.AI รายงานชี้ว่า MAI-DxO แบบไม่จำกัดงบแพงกว่าแพทย์ที่เปิดตำราได้ ความถูกจึงขึ้นกับการตั้งค่า
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
AI ทำโจทย์วินิจฉัยบนกระดาษได้ดีกว่าแพทย์ทั่วไปที่ทำงานคนเดียวจริง แต่ยังห่างไกลจากคำว่า "เก่งกว่าหมอ" งานนี้มีจุดแข็งที่ควรให้เครดิต คือผ่านการตรวจของวารสาร Science เปิดชุดทดสอบให้คนอื่นใช้ เพิ่มกลุ่มแพทย์ที่เปิดตำราได้หลังถูกวิจารณ์เมื่อปีก่อน และเพิ่มเคสห้องฉุกเฉินที่ใกล้ชีวิตจริงขึ้น แต่สามเรื่องทำให้ต้องอ่านอย่างระวัง ข้อแรก ผู้ที่ถูกเทียบไม่ใช่ผู้เชี่ยวชาญที่ปกติรับเคสระดับนี้ ข้อสอง ความแม่นส่วนใหญ่มาจากโมเดลของ OpenAI ที่ใครก็เรียกใช้ได้ ไม่ใช่จากระบบของ Microsoft เอง ข้อสาม คำว่า "medical superintelligence" ของ Suleyman ไปไกลกว่าที่บทคัดย่อของงานกล้าพูด ซึ่งเขียนเพียงว่าผลนี้ "ชี้ถึงศักยภาพ" ในการช่วยวินิจฉัย ReadEval ประเมินว่าตัวชี้ขาดคือผลการทดสอบกับคนไข้จริงที่บอสตัน ซึ่งจะบอกได้ว่าระบบช่วยหรือทำให้สับสน และช่วยใครบ้าง ระหว่างนี้ ข่าวนี้ไม่ได้เปลี่ยนคำแนะนำสำหรับคนทั่วไป ถ้าคุณไม่สบาย ให้ไปพบแพทย์ และถ้าใช้แชตบอตหาข้อมูลสุขภาพ ให้ใช้เตรียมคำถามไปคุยกับแพทย์ ไม่ใช่ใช้แทนการตรวจ
แหล่งที่มา
- Science: Sequential diagnosis with language models (Nori et al., 22 ต.ค. 2026) — บทคัดย่อและข้อมูลผู้เขียนผ่าน Crossref/Europe PMC
- Microsoft AI: Building Medical Superintelligence (22 ต.ค. 2026)
- Microsoft: SDBench — Sequential Diagnosis Benchmark
- GitHub: microsoft/sdbench (README)
- arXiv: Sequential Diagnosis with Language Models (ฉบับก่อนตีพิมพ์ มิ.ย. 2025)
- Microsoft AI: The Path to Medical Superintelligence (30 มิ.ย. 2025)
- Microsoft AI: Introducing Copilot Health (12 มี.ค. 2026)
- TechCrunch: Suleyman says Microsoft's AI outperforms doctors on hard cases
- The Next Web: Microsoft AI tool beat generalist doctors at step-by-step diagnosis
- Unite.AI: Microsoft diagnostic AI outperforms generalist physicians in Science study
- TIME: Microsoft's AI is better than doctors at diagnosing disease (2 ก.ค. 2025)