Google ให้ทนายใช้ AI 3 เดือน รุ่นน้องเขียนงานดีขึ้น แต่พอปิด AI ฝีมือไม่เพิ่มเหมือนรุ่นพี่
งานวิจัย NBER ที่ Google ดำเนินการและให้ทุนพบ AI ช่วยทนายรุ่นน้องเขียนงานดีขึ้นมากสุด แต่พอห้ามใช้ AI มีแค่รุ่นพี่ที่ฝีมือดีขึ้น
สารบัญ (15 หัวข้อ)
- สรุปประเด็นสำคัญ
- การทดลองทำอย่างไร
- "0.38 SD" แปลว่าอะไร
- ตอนได้ใช้ AI งานดีขึ้นแค่ไหน
- พอปิด AI แล้วเกิดอะไรขึ้น
- รุ่นน้องที่ใช้ AI "แย่ลง" หรือเปล่า
- ทำไมรุ่นพี่ได้ แต่รุ่นน้องไม่ได้
- Google เกี่ยวข้องกับงานนี้แค่ไหน
- ผลนี้แข็งแรงแค่ไหน
- คะแนนความน่าเชื่อถือ
- งานวิจัยอื่นบอกอะไร
- ใช้ AI อย่างไรให้ยังได้ฝึกฝีมือ
- เกี่ยวกับคนไทยไหม
- สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- บทวิเคราะห์จาก ReadEval
ถ้าคุณเพิ่งเริ่มทำงานและใช้ AI ช่วยเขียนงานทุกวัน งานทดลองชิ้นใหม่มีทั้งข่าวดีและคำเตือนในคราวเดียว David Autor นักเศรษฐศาสตร์จาก MIT กับทีมนักวิจัยของ Google ทดลองกับทนายความด้านสิทธิบัตรในสหรัฐฯ 133 คนนาน 3 เดือน แล้วพบว่ากลุ่มที่ AI ช่วยให้เขียนงานดีขึ้นมากที่สุด กลับเป็นกลุ่มที่ฝีมือไม่ได้เพิ่มขึ้นเลยเมื่อต้องทำงานโดยไม่มี AI
ทีมวิจัยจับฉลากให้ทนายส่วนใหญ่ได้ใช้ผู้ช่วยเขียนคำขอสิทธิบัตรที่ Google Labs พัฒนา ส่วนที่เหลือทำงานแบบเดิม แล้วให้ทนายจากสำนักงานอื่นตรวจงานโดยไม่รู้ว่าชิ้นไหนมาจากกลุ่มไหน ตอนได้ใช้ AI งานของทนายดีขึ้นทุกด้าน โดยทนายรุ่นน้องที่ทำงานมาไม่ถึง 7 ปีได้ประโยชน์มากที่สุด แต่ในบททดสอบสุดท้ายที่ทุกคนต้องตรวจแก้ร่างคำขอสิทธิบัตรโดยห้ามใช้ AI รุ่นพี่ที่เคยใช้ AI ทำได้ดีกว่ารุ่นพี่ที่ไม่เคยใช้ แต่รุ่นน้องที่เคยใช้ได้คะแนนเฉลี่ยเท่ากับรุ่นน้องที่ไม่ได้ใช้ และคะแนนแตกเป็นสองทาง มีทั้งคนที่ทำได้ดีและคนที่ทำได้แย่มากกว่าอีกกลุ่ม
ภาพที่ใกล้เคียงคือการขับรถด้วย GPS คนที่รู้จักเมืองดีอยู่แล้วใช้ GPS เช็กเส้นทาง แล้วเก็บทางลัดใหม่ ๆ ไว้ในหัว ส่วนคนที่เพิ่งย้ายมาก็ถึงที่หมายได้เหมือนกัน แต่พอปิด GPS ก็ยังจำทางไม่ได้ ผู้วิจัยเสนอว่าความรู้พื้นฐานอาจเป็นเงื่อนไขของการเรียนรู้จาก AI แต่ภาพนี้ต่างจากงานวิจัยตรงที่ทีมวิจัยยังไม่ได้พิสูจน์ว่าเกิดจากอะไร และรุ่นน้องบางส่วนก็ทำได้ดีขึ้นจริง
อ่านผลนี้ควรรู้ข้อจำกัดด้วย นี่เป็นงานวิจัยฉบับร่างที่ยังไม่ผ่านการตรวจโดยผู้ทรงคุณวุฒิ Google เป็นผู้ดำเนินการทดลองและจ่ายค่าใช้จ่าย ผู้เขียนเกือบทั้งหมดทำงานให้ Google และเครื่องมือที่ทดสอบก็เป็นของ Google เอง กลุ่มตัวอย่างก็เล็กและมีแค่งานกฎหมายสิทธิบัตรในสหรัฐฯ ยังไม่มีข้อมูลว่าผลจะเป็นแบบเดียวกันกับคนทำงานในไทยหรือในอาชีพอื่นหรือไม่
ถ้าคุณใช้ ChatGPT หรือ Gemini ทำงานทุกวัน ลองสลับมาทำบางงานเองก่อน แล้วค่อยให้ AI ช่วยวิจารณ์ และหมั่นเช็กว่าถ้าไม่มี AI คุณยังทำงานนั้นได้ดีแค่ไหน ส่วนตัวเลขทั้งหมด วิธีทดลอง บทบาทของ Google และคะแนนความน่าเชื่อถืออยู่ด้านล่าง
สรุปประเด็นสำคัญ
- งานวิจัย: "Does AI Assistance Enhance or Erode Expertise? Evidence from a Three-Month Field Experiment in Patent Drafting" เป็น NBER Working Paper 35720 ออกเมื่อกันยายน 2026 และปรับปรุงเมื่อตุลาคม 2026 ผู้เขียน 7 คน คือ David Autor (MIT) และอีก 6 คนที่เป็นพนักงานหรือผู้รับจ้างของ Google ลงทะเบียนแผนการทดลองไว้ล่วงหน้าตั้งแต่ 21 พ.ค. 2025 และยังไม่ผ่าน peer review
- ตอนใช้ AI เขียนงาน: กลุ่มที่ได้ใช้ AI ได้คะแนนสูงกว่ากลุ่มที่ไม่ได้ใช้ 0.34 SD ที่วันที่ 10 และ 0.38 SD ที่วันที่ 90 รุ่นน้องได้เพิ่ม 0.58 และ 0.60 SD ส่วนรุ่นพี่ได้เพิ่ม 0.22 และ 0.30 SD ซึ่งยังไม่ชัดทางสถิติ
- ตอนตรวจแก้งานโดยไม่มี AI: ภาพรวมกลุ่มที่เคยใช้ AI ดีกว่า 0.32 SD แต่ทั้งหมดมาจากรุ่นพี่ (0.45 SD) ส่วนรุ่นน้องได้ −0.03 SD หรือแทบไม่ต่าง และคะแนนกระจายออก ได้คะแนนแย่มากขึ้น คะแนนระดับพอใช้น้อยลง และคะแนนดีเพิ่มขึ้นบ้าง แต่คะแนนระดับยอดเยี่ยมไม่เพิ่ม
- ความน่าเชื่อถือ: 🟡 พอใช้อ้างอิงได้ (4 จาก 6 ข้อตามเกณฑ์ของ ReadEval) ออกแบบเป็นการทดลองแบบสุ่มที่ดี ให้ผู้ตรวจที่ไม่รู้กลุ่มเป็นคนให้คะแนน และบอกข้อจำกัดครบ แต่ Google เป็นทั้งผู้ทำการทดลอง ผู้ให้ทุน และเจ้าของเครื่องมือ ข้อมูลไม่ได้เปิดให้คนนอกตรวจซ้ำ และงานยังไม่ผ่าน peer review
การทดลองทำอย่างไร
ทีมวิจัยติดต่อสำนักงานกฎหมายด้านทรัพย์สินทางปัญญา 24 แห่งที่รับงานจาก Google เป็นประจำ (แต่ไม่ได้รับงานจาก Google เพียงรายเดียว) มี 11 แห่งที่ตกลงเข้าร่วม สำนักงานส่งทนายมา 156 คน และมี 133 คนที่ผ่านขั้นเตรียมตัวและถูกสุ่มแบ่งกลุ่ม ทนายได้ค่าตอบแทนตามอัตรารายชั่วโมงปกติสำหรับเวลาที่ใช้ทำงานทดลอง และการทดลองเกิดขึ้นระหว่างพฤษภาคม 2025 ถึงกุมภาพันธ์ 2026
- การแบ่งกลุ่ม: สุ่มภายในแต่ละสำนักงาน ตั้งเป้าสัดส่วน 2:1 ได้กลุ่มใช้ AI 90 คน และกลุ่มไม่ใช้ AI 43 คน โดยแยกสุ่มตามระดับประสบการณ์ ผู้วิจัยบอกว่าเลือกสัดส่วนนี้เพราะสำนักงานกฎหมายอยากให้ทนายของตัวเองได้ใช้ AI เร็วขึ้น
- กลุ่มไม่ใช้ AI: ใช้เครื่องมือกฎหมายตามปกติ แต่ไม่ได้ใช้ AI ช่วยเขียน ทั้งสองกลุ่มได้บทเรียนพื้นฐานเรื่อง AI เหมือนกัน ส่วนกลุ่มใช้ AI ได้บทเรียนเพิ่มเรื่องวิธีใช้เครื่องมือ คลังคำสั่งสำหรับงานสิทธิบัตร และข้อผิดพลาดที่พบบ่อย
- งานวันที่ 10: เขียนข้อถือสิทธิ์ย่อย (dependent claims) 5–7 ข้อ พร้อมคำอธิบายการประดิษฐ์โดยละเอียด จากรูปและโน้ตของ "ผู้ประดิษฐ์" สมมุติ ใช้เวลาไม่เกิน 2 ชั่วโมงและไม่เกิน 1,000 คำ
- งานวันที่ 90: งานเขียนแบบเดียวกันแต่ยากขึ้น ไม่เกิน 2,000 คำ กับงานตรวจแก้ (redlining) ที่ทุกคนต้องแก้ร่างคำขอสิทธิบัตรที่ AI เขียนไว้ด้วยการแก้ตรงจุดและใส่ความเห็น โดยห้ามใช้ AI
- การให้คะแนน: ทนายผู้เชี่ยวชาญ 2 คนต่องาน สุ่มจาก 6 คนของสำนักงานกฎหมายที่ทีมวิจัยจ้าง ไม่รู้ว่างานมาจากกลุ่มไหน ให้คะแนน 5 ด้าน คือ การบังคับใช้ได้ทางกฎหมาย ความถูกต้องทางเทคนิค ความกว้างของถ้อยคำเชิงกลยุทธ์ ความครบถ้วน และความชัดเจน
- คนที่ทำครบ: 105 คนส่งงานวันที่ 10, 98 คนส่งงานเขียนวันที่ 90 และ 91 คนส่งงานตรวจแก้ การหลุดออกไม่ต่างกันระหว่างสองกลุ่มอย่างมีนัยสำคัญ
เครื่องมือที่ใช้คืออะไร งานวิจัยไม่ได้ระบุชื่อ บอกเพียงว่าเป็นผลิตภัณฑ์ที่ยังไม่เปิดตัวของ Google Labs สำหรับช่วยเขียนงานในสายบริการวิชาชีพ ทำได้ เช่น แก้ข้อความตามคำสั่ง ให้ความเห็นจาก "บรรณาธิการ AI" หลายบุคลิก และตรวจหาจุดที่ขัดกันในเอกสาร ระหว่างการทดลองมีการเพิ่มฟีเจอร์ตรวจแก้อัตโนมัติเมื่อกรกฎาคม 2025 ภายหลังเครื่องมือนี้ไม่ได้เปิดเป็นผลิตภัณฑ์แยก แต่ฟีเจอร์ถูกรวมเข้าไปในผลิตภัณฑ์ AI อื่นของ Google
"0.38 SD" แปลว่าอะไร
ตัวเลขในงานนี้ไม่ใช่เปอร์เซ็นต์ แต่เป็นหน่วยส่วนเบี่ยงเบนมาตรฐาน (SD) ทีมวิจัยปรับคะแนนให้กลุ่มที่ไม่ได้ใช้ AI มีค่าเฉลี่ยเป็น 0 และความต่างระหว่างคนตามปกติเป็น 1 หน่วย ดังนั้น 0.38 SD แปลว่ากลุ่มที่ใช้ AI ได้คะแนนสูงกว่าเกือบ 4 ใน 10 ของความต่างตามปกติระหว่างทนายในกลุ่มที่ไม่ได้ใช้ บล็อกของ Google Research แปลงตัวเลขเหล่านี้ให้ว่าเท่ากับขยับอันดับขึ้นราว 9–13 เปอร์เซ็นไทล์
ตอนได้ใช้ AI งานดีขึ้นแค่ไหน
| วัดอะไร | ทุกคน | รุ่นน้อง (ไม่ถึง 7 ปี) | รุ่นพี่ (7 ปีขึ้นไป) |
|---|---|---|---|
| คุณภาพงานเขียนวันที่ 10 | +0.34 SD | +0.58 SD | +0.22 SD (ยังไม่ชัด) |
| คุณภาพงานเขียนวันที่ 90 | +0.38 SD | +0.60 SD | +0.30 SD (ยังไม่ชัด) |
| เวลาที่ใช้เขียนวันที่ 10 | เร็วขึ้นราว 10 นาที จากเฉลี่ย 110 นาที | เร็วขึ้นราว 18 นาที | เร็วขึ้นราว 5 นาที (ยังไม่ชัด) |
ตัวเลขมาจากตาราง 3, 4 และ 8 ของงานวิจัย คะแนนดีขึ้นทั้ง 5 ด้าน และส่วนใหญ่มาจากงานที่แย่มากลดลง ไม่ใช่งานยอดเยี่ยมเพิ่มขึ้น ที่วันที่ 10 สัดส่วนคะแนนกลุ่มต่ำสุดลดลง 19 จุดเปอร์เซ็นต์ เมื่อมี AI ช่วย รุ่นน้องเขียนงานได้ดีกว่ารุ่นพี่ที่ไม่ได้ใช้ AI ในการทดสอบวันที่ 10
ทนายเองก็รู้สึกว่าเร็วขึ้นชัดเจน และรุ่นน้องรู้สึกว่างานมีคุณภาพดีขึ้น งานวิจัยชี้ว่าความรู้สึกนี้ถูกต้องสำหรับงานที่ทำร่วมกับ AI แต่ไม่ตรงกับผลของงานที่ต้องทำเอง
พอปิด AI แล้วเกิดอะไรขึ้น
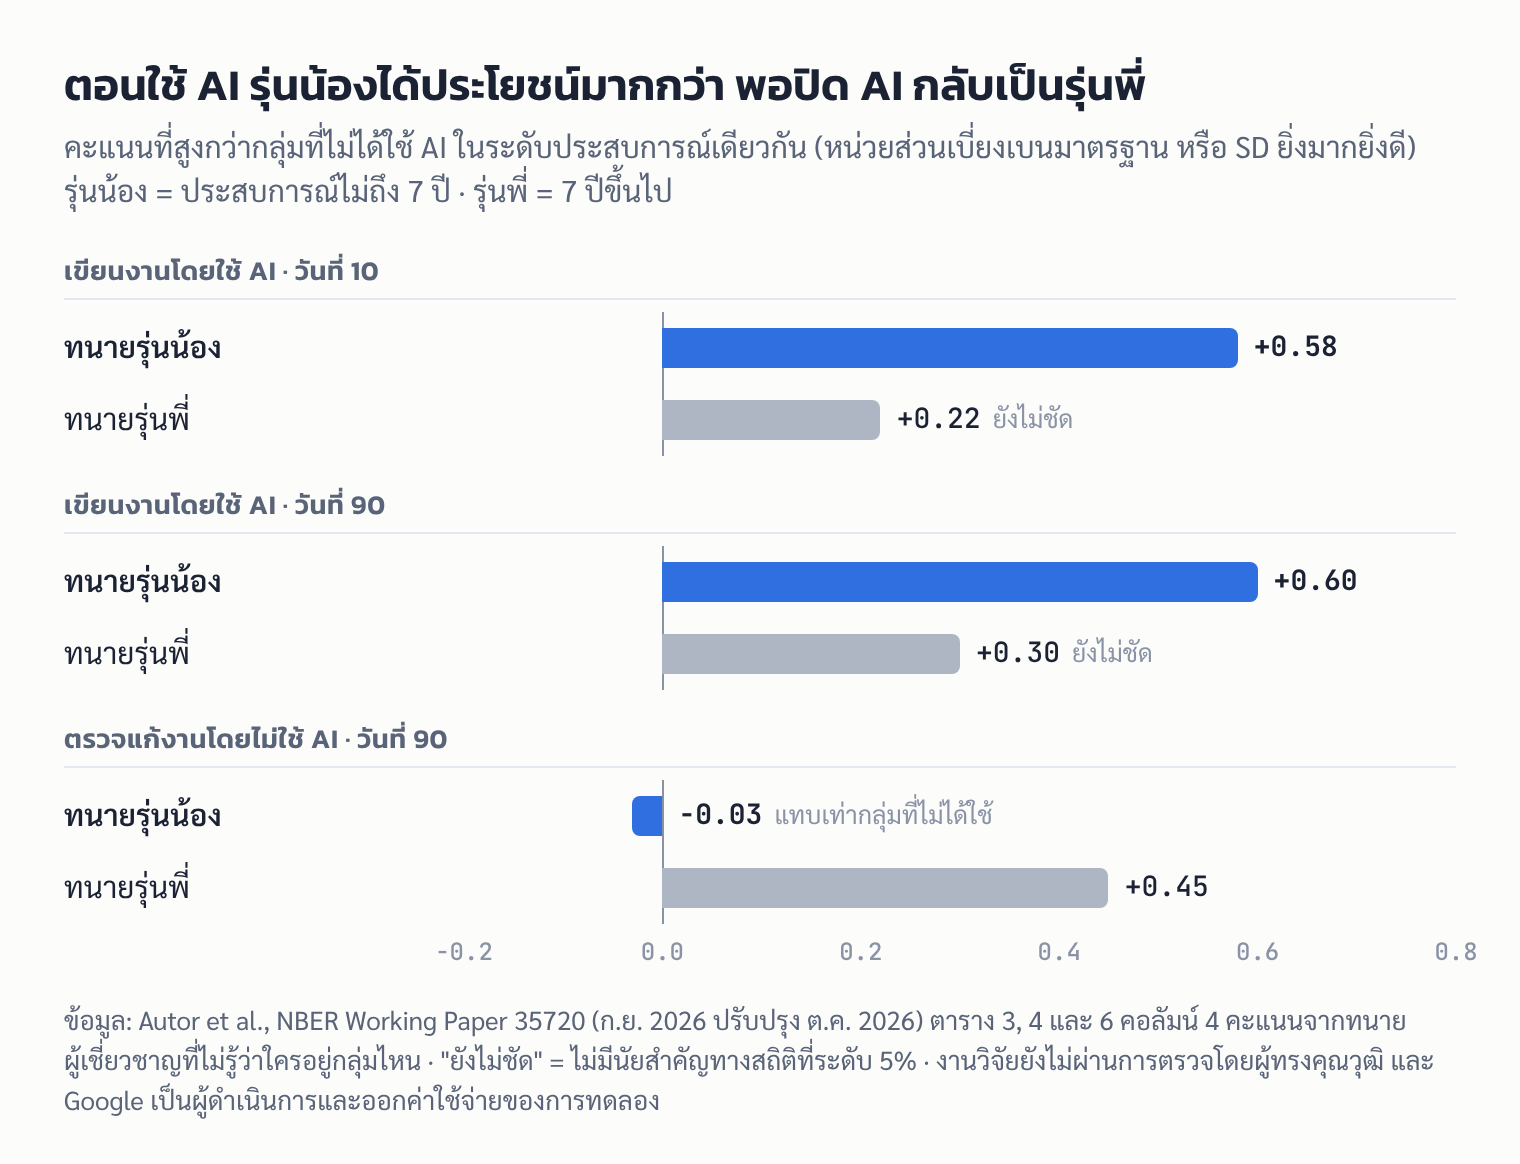
งานตรวจแก้ร่างคำขอสิทธิบัตรเป็นงานที่ทนายทำเองเป็นประจำและต้องใช้วิจารณญาณมาก ผลภาพรวมคือกลุ่มที่เคยใช้ AI 3 เดือนทำได้ดีกว่า 0.32 SD แต่เมื่อแยกตามประสบการณ์ ผลกลับด้านจากตอนเขียนงาน รุ่นพี่ที่เคยใช้ AI ดีกว่ารุ่นพี่ที่ไม่ได้ใช้ 0.45 SD และดีกว่าในทั้ง 5 ด้าน ส่วนรุ่นน้องได้ −0.03 SD ซึ่งแทบเท่ากลุ่มที่ไม่ได้ใช้ ในกลุ่มที่ไม่ได้ใช้ AI รุ่นน้องกับรุ่นพี่ทำงานนี้ได้พอ ๆ กัน แต่หลังใช้ AI 3 เดือน ช่องว่างระหว่างรุ่นพี่กับรุ่นน้องก็เกิดขึ้น
ทีมวิจัยแบ่งคะแนนทั้งหมดเป็น 5 ขั้นเท่า ๆ กัน (quintile) แล้วดูว่ากลุ่มที่ใช้ AI มีสัดส่วนในแต่ละขั้นต่างจากกลุ่มที่ไม่ได้ใช้เท่าไร
| ขั้นคะแนนงานตรวจแก้ | รุ่นน้อง | รุ่นพี่ |
|---|---|---|
| ยอดเยี่ยม (ขั้นบนสุด) | +6 จุด (ยังไม่ชัด) | +3 จุด (ยังไม่ชัด) |
| ดี | +19 จุด (ยังไม่ชัด) | +22 จุด |
| กลาง ๆ | −5 จุด (ยังไม่ชัด) | −4 จุด (ยังไม่ชัด) |
| พอใช้ | −42 จุด | −8 จุด (ยังไม่ชัด) |
| แย่ (ขั้นล่างสุด) | +22 จุด | −14 จุด (ยังไม่ชัดที่ระดับ 5%) |
หน่วยเป็นจุดเปอร์เซ็นต์ของสัดส่วนคะแนน จากตาราง 7 ของงานวิจัย ผู้วิจัยเรียกรูปแบบของรุ่นน้องว่าคะแนน "แยกเป็นสองทาง" และตีความว่า AI อาจเป็น "สปริงบอร์ด" ให้รุ่นน้องบางคน แต่เป็น "เบาะรองรับ" ที่ทำให้บางคนไม่ได้ฝึกเอง
รุ่นน้องที่ใช้ AI "แย่ลง" หรือเปล่า
ไม่ใช่แบบนั้นเสียทีเดียว โดยเฉลี่ยรุ่นน้องที่ใช้ AI ทำงานตรวจแก้ได้เท่ากับรุ่นน้องที่ไม่ได้ใช้ สิ่งที่เปลี่ยนคือการกระจาย คะแนนระดับพอใช้หายไปมาก ขณะที่คะแนนแย่เพิ่มขึ้นอย่างมีนัยสำคัญ และคะแนนดีเพิ่มขึ้นบ้างแต่ยังไม่ชัดทางสถิติ ที่สำคัญคือสัดส่วนในกลุ่มยอดเยี่ยมไม่ได้เพิ่มอย่างมีนัยสำคัญ คำว่า "บางคนเก่งขึ้น" จึงหมายถึงขึ้นมาอยู่ระดับดี ไม่ใช่ระดับดีที่สุด
ควรรู้ด้วยว่ากลุ่มรุ่นน้องในงานตรวจแก้มีขนาดเล็กมาก ตาราง 2 ของงานวิจัยแสดงคะแนนจากผู้ตรวจ 14 คะแนนในกลุ่มไม่ใช้ AI และ 36 คะแนนในกลุ่มใช้ AI เมื่อแต่ละคนได้คะแนนจากผู้ตรวจประมาณ 2 คน ReadEval ประเมินว่ามีรุ่นน้องในส่วนนี้ราว 25 คนเท่านั้น ผู้วิจัยเองก็ยอมรับว่าตัวเลขของรุ่นน้องแม่นยำน้อยกว่าของรุ่นพี่
ทำไมรุ่นพี่ได้ แต่รุ่นน้องไม่ได้
งานวิจัยบอกตรง ๆ ว่าการทดลอง "ไม่ได้ตอบว่าทำไม" ผลจึงออกมาดีกับบางคนและแย่กับบางคน แต่มีคำอธิบายที่เป็นไปได้ 3 ทาง
- ต้องมีพื้นฐานก่อน: ข้อสรุปเบื้องต้นของผู้วิจัยคือความเชี่ยวชาญพื้นฐานอาจเป็นเงื่อนไขของการเปลี่ยนการทำงานกับ AI ให้เป็นทักษะที่ติดตัว
- เวลาฝึกที่หายไป: รุ่นน้องที่ใช้ AI เขียนงานเร็วขึ้น ขณะที่รุ่นพี่เขียนได้ดีขึ้นแต่แทบไม่เร็วขึ้น ผู้วิจัยเทียบกับงานวิจัยในนักเรียนมัธยมจีนที่พบว่าคนที่ใช้ AI แล้วใช้เวลาทำการบ้านน้อยลง ได้คะแนนการบ้านสูงขึ้นแต่คะแนนสอบจริงลดลง ส่วนคนที่ยังใช้เวลาเท่าเดิมได้ผลใกล้เคียงคนที่ไม่ได้ใช้ แต่ย้ำว่าทั้งสองงานไม่ได้ทดสอบว่าเวลาเป็นสาเหตุจริง
- วิธีตรวจงานต่างกัน: บล็อกของ Google Research อ้างการวิเคราะห์เพิ่มเติมว่ารุ่นพี่ใช้เวลากับงานตรวจแก้นานกว่า สร้างข้อถือสิทธิ์ใหม่ทั้งข้อ และอ้างหลักกฎหมายประกอบการแก้ บางคนบอกในการสัมภาษณ์ว่าใช้ AI เป็น "ผู้ตรวจตรรกะ" ไม่ใช่ของสำเร็จรูป ส่วนรุ่นน้องมักไล่แก้ทีละส่วน ใช้เวลาเกลาถ้อยคำในส่วนที่ไม่สำคัญ และชี้จุดผิดได้แต่ไม่แก้ ทั้งนี้รูปแบบนี้พบในรุ่นน้องกลุ่มที่ไม่ได้ใช้ AI ด้วย ผู้วิจัยจึงเรียกว่าเป็นจุดอ่อนพื้นฐานของรุ่นน้องที่ AI ไม่ได้ช่วยแก้ มากกว่านิสัยที่ AI สร้างขึ้น
Google เกี่ยวข้องกับงานนี้แค่ไหน
หน้าเปิดเผยข้อมูลของงานวิจัยและหน้าเว็บ NBER ระบุไว้ดังนี้
- ผู้ดำเนินการ: "การศึกษานี้ดำเนินการโดย Google" และผู้เข้าร่วมให้ความยินยอมตามขั้นตอนวิจัยของ Google
- ทุน: Google จ่ายค่าใช้จ่ายโดยตรงของการทดลอง ส่วน Autor ได้รับการสนับสนุนจากหลายแหล่ง รวมถึงโครงการ Google Technology and Society Visiting Fellows
- ผู้เขียน: Tanya Rodchenko, Zanna Iscenko, Scott Strand, David Pearl และ Melissa Ferere เป็นพนักงานเต็มเวลาของ Google ที่ได้หุ้นเป็นส่วนหนึ่งของค่าตอบแทนหรือถือหุ้น Google ส่วน Josh Martin เปิดเผยว่าเป็นผู้รับจ้างของ Google
- เครื่องมือ: ผู้ช่วยเขียนที่ทดสอบเป็นของ Google Labs
- ผู้เข้าร่วม: สำนักงานกฎหมายทั้งหมดรับงานเขียนสิทธิบัตรให้ Google และ Google ช่วยหาผู้เข้าร่วม
- เกณฑ์ให้คะแนน: พัฒนาร่วมกับฝ่ายกฎหมายของ Google และเส้นแบ่ง 7 ปีระหว่างรุ่นน้องกับรุ่นพี่ก็มาจากคำแนะนำของฝ่ายกฎหมายของ Google
สิ่งที่ช่วยถ่วงดุลคือ ทีมวิจัยลงทะเบียนแผนการทดลองไว้ล่วงหน้าในทะเบียนของสมาคมเศรษฐศาสตร์อเมริกัน (AEARCTR-0015823) และผู้ตรวจเป็นทนายจากสำนักงานภายนอกที่ไม่รู้ว่างานมาจากกลุ่มไหน ReadEval ตั้งข้อสังเกตด้วยว่าผลหลักไม่ได้เป็นข่าวดีกับเครื่องมือ AI ไปทั้งหมด เพราะรุ่นน้องซึ่งได้ประโยชน์มากที่สุดตอนใช้งานกลับไม่ได้ฝีมือเพิ่ม
ผลนี้แข็งแรงแค่ไหน
ทีมวิจัยทดสอบความทนทานของผลไว้หลายแบบ และบางแบบก็ทำให้ผลอ่อนลง
- แอบใช้ AI ในงานที่ห้ามใช้: ทีมวิจัยตรวจไม่ได้ว่าใครใช้ AI ระหว่างตรวจแก้ จึงให้ AI และทีมงานหาร่องรอยของข้อความจาก AI พบงานที่อาจใช้ AI 15 จาก 91 ชิ้น (ในกลุ่มไม่ใช้ AI ก็มี 4 ชิ้น) เมื่อตัดงานเหล่านี้ออก ผลรวมลดเหลือ 0.25 SD และไม่ชัดทางสถิติแล้ว แต่ผลของรุ่นพี่ยังอยู่ที่ 0.39 SD และยังชัดที่ระดับ 10%
- สำนักงานเดียวมีผลมาก: ถ้าตัดสำนักงานที่มีทนายรุ่นพี่ 6 คนออก ผลรวมเหลือ 0.22 SD และไม่ชัดทางสถิติ แต่ผลของรุ่นพี่ยังชัดที่ระดับ 10%
- เปลี่ยนเส้นแบ่งรุ่นพี่รุ่นน้อง: ลองเส้นแบ่งตั้งแต่ 3 ถึง 11 ปี รุ่นพี่ยังได้ผลบวกทุกแบบ ส่วนรุ่นน้องไม่ชัดทุกแบบ
- ให้ AI ช่วยตรวจซ้ำ: ทีมวิจัยให้ Gemini 2.5 Flash ให้คะแนนซ้ำ ได้ทิศทางเดียวกันแต่ตัวเลขใหญ่กว่า อย่างไรก็ตามคะแนนจาก AI สอดคล้องกับคะแนนของทนายน้อย ผู้วิจัยจึงถือว่าเป็นผู้ตรวจที่น่าเชื่อถือน้อยกว่า
- แผนที่ลงทะเบียนไว้ต่างจากที่ทำจริง: หน้าทะเบียนการทดลองตั้งเป้าผู้เข้าร่วมสูงสุด 350 คน (ได้จริง 133 คน) และวางแผนให้ทำงานเขียนพร้อมงานวิจารณ์และตรวจแก้ร่างสิทธิบัตรทั้งสองรอบ รวมถึงเทียบงานจริงที่ทนายเขียนให้ Google ด้วย แต่ในงานวิจัยฉบับนี้ งานตรวจแก้โดยห้ามใช้ AI มีแค่รอบวันที่ 90 และถูกเพิ่มเข้ามาหลังสำนักงานแรกทำการทดลองเสร็จแล้ว ส่วนการเทียบงานจริงทำไม่ได้เพราะงานเขียนให้ Google มีน้อยและทำกันเป็นทีม
- ข้อจำกัดที่ผู้วิจัยยอมรับเอง: กลุ่มตัวอย่างเล็กเพราะค่าตัวทนายแพง ผู้เข้าร่วมมาจากสำนักงานที่รับงานจากลูกค้ารายใหญ่จึงไม่ได้เป็นตัวแทนของงานบริการวิชาชีพทั่วไป ไม่มีการวัดฝีมือก่อนเริ่มทดลอง (สำนักงานกฎหมายไม่ยอม) และ 3 เดือนนั้นสั้นมากเมื่อเทียบกับเวลาหลายปีที่ใช้สร้างความเชี่ยวชาญด้านสิทธิบัตร
Tyler Cowen ผู้เขียนบล็อกเศรษฐศาสตร์ Marginal Revolution ซึ่งหยิบงานนี้ไปเขียนถึงตั้งแต่กลางเดือนกันยายน ชี้อีกมุมว่าการทดลองแบบสุ่มต้องตรึงหลายอย่างให้คงที่ จึงอาจมองไม่เห็นว่าเมื่อเวลาผ่านไป องค์กรจะปรับการแบ่งงานให้คนกับ AI อย่างไร
คะแนนความน่าเชื่อถือ
| เกณฑ์ | ผ่านไหม | เหตุผล |
|---|---|---|
| ทำซ้ำได้ | ไม่ผ่าน | ไม่มีข้อมูลหรือโค้ดเปิดให้คนนอกรันซ้ำ และเครื่องมือไม่ได้เปิดเป็นผลิตภัณฑ์แยก |
| บอกสภาพแวดล้อมครบ | ผ่าน | บอกขั้นตอน งานที่ใช้ทดสอบ เกณฑ์ให้คะแนน จำนวนคนในแต่ละสำนักงาน และช่วงเวลา |
| วัดหลายรอบและบอกความแปรปรวน | ผ่าน | ผู้ตรวจ 2 คนต่องาน รายงานค่าคลาดเคลื่อน ค่า p และทดสอบแบบสุ่มสลับกลุ่ม 2,000 รอบ |
| เทียบอย่างยุติธรรม | ผ่าน | สุ่มแบ่งกลุ่มภายในสำนักงาน ลงทะเบียนแผนล่วงหน้า และผู้ตรวจไม่รู้กลุ่ม |
| เป็นอิสระ | ไม่ผ่าน | Google ดำเนินการ ให้ทุน และเป็นเจ้าของเครื่องมือ ผู้เขียน 6 จาก 7 คนทำงานให้ Google เปิดเผยครบ แต่ยังไม่มีบุคคลที่สามทำซ้ำ |
| ยอมรับข้อจำกัด | ผ่าน | บอกข้อจำกัดเรื่องขนาดกลุ่ม ความเป็นตัวแทน การไม่มีการวัดก่อนทดลอง และการแอบใช้ AI |
รวม 4 จาก 6 ข้อ ได้ระดับ 🟡 พอใช้อ้างอิงได้ ควรอ่านเป็นหลักฐานชิ้นสำคัญที่ยังต้องรอการตรวจโดยผู้ทรงคุณวุฒิและการทดลองซ้ำจากทีมอื่น
งานวิจัยอื่นบอกอะไร
ผลของงานวิจัยด้านนี้ยังไปคนละทาง ซึ่งงานของ Autor ก็สรุปไว้เอง
- AI ทำให้เรียนรู้น้อยลง: การทดลองกับนักเรียนมัธยมราว 1,000 คนพบว่าการใช้ GPT-4 แบบไม่จำกัดช่วยให้ทำแบบฝึกหัดได้ดีขึ้น แต่คะแนนสอบที่ไม่ใช้ AI ลดลง อีกงานพบว่าวิศวกรซอฟต์แวร์ที่ใช้ AI ช่วยเรียนไลบรารีใหม่เข้าใจหลักการและอ่านโค้ดได้แย่ลง
- AI ช่วยให้เรียนรู้ได้: แพทย์รังสีมือใหม่ที่ฝึกกับ AI วินิจฉัยเองได้แม่นขึ้นภายหลัง และนักศึกษากฎหมายที่เคยใช้ AI ทำได้ดีกว่าในงานถัดมาที่ไม่ให้ใช้ AI
- ตัวแปรที่อาจสำคัญคือวิธีใช้: ในการทดลองกับนักเรียนมัธยมชิ้นเดียวกัน เมื่อปรับ AI ให้ทำตัวเป็นติวเตอร์ที่ไม่บอกคำตอบและให้นักเรียนคิดเอง ผลเสียต่อคะแนนสอบก็หายไป
ใช้ AI อย่างไรให้ยังได้ฝึกฝีมือ
งานวิจัยนี้ไม่ได้ทดสอบวิธีใช้ AI แบบต่าง ๆ ข้อแนะนำด้านล่างจึงเป็นข้อเสนอของ ReadEval ที่อิงจากผลของงานนี้และงานวิจัยในนักเรียนมัธยมข้างต้น
- ลองทำเองก่อนในงานที่อยากเก่ง ร่างเองสักรอบ แล้วค่อยให้ AI วิจารณ์ แทนการให้ AI ร่างตั้งแต่ต้น
- ขอคำถาม ไม่ใช่คำตอบ สั่งให้ AI ชี้จุดอ่อนแล้วถามกลับว่าคุณจะแก้อย่างไร ตัวอย่างคำสั่ง
อย่าเขียนใหม่ให้ ช่วยชี้จุดอ่อน 3 ข้อในร่างนี้ บอกว่าแต่ละข้อมีปัญหาเพราะอะไร แล้วถามฉันว่าจะแก้อย่างไร- แก้เอง ไม่ใช่แค่ชี้ ถ้า AI บอกว่าตรงไหนผิด ให้ลงมือแก้เองและอธิบายได้ว่าแก้เพราะอะไร
- ทดสอบตัวเองแบบไม่มี AI เป็นระยะ เช่น ทำงานชิ้นเล็กเองทั้งหมดเดือนละครั้ง แล้วเทียบกับงานที่ทำร่วมกับ AI
- สำหรับหัวหน้าทีม ผู้วิจัยสรุปว่าการประเมินผลของ AI ต่อการพัฒนาทักษะต้อง "แยกส่วนที่มาจากซอฟต์แวร์ออกจากความเชี่ยวชาญของผู้ใช้" ถ้าดูแต่งานที่ส่ง คุณอาจไม่รู้ว่าน้องในทีมเก่งขึ้นจริงหรือไม่
เกี่ยวกับคนไทยไหม
งานนี้ทดลองเฉพาะทนายสิทธิบัตรในสหรัฐฯ ไม่มีข้อมูลจากไทย และยังไม่ได้รับการยืนยันว่าผลจะเหมือนกันในงานอื่นหรือในประเทศอื่น เครื่องมือที่ใช้ทดลองก็ไม่ได้เปิดขายแยก สิ่งที่นำมาใช้ได้คือคำถามที่งานนี้ตั้งไว้ ว่างานที่ดีขึ้นเพราะ AI กับฝีมือที่ติดตัวคนทำเป็นคนละเรื่องกัน ส่วนเรื่องที่บริษัทเทคโนโลยีรับพนักงานระดับเริ่มต้นน้อยลง ReadEval เคยรายงานไว้ในข่าวตัวเลขการจ้างงานจูเนียร์ของ Anthropic
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- ชื่อเครื่องมือ: งานวิจัยไม่ได้ระบุชื่อ The Decoder เรียกว่า "InFlow" ส่วนบล็อกของ Google Research บอกว่าตอนนี้เป็นส่วนหนึ่งของ Gemini Notebook ขณะที่งานวิจัยเขียนเพียงว่าฟีเจอร์ถูกรวมเข้าผลิตภัณฑ์ AI อื่นของ Google ReadEval ยังยืนยันชื่อ InFlow จากเอกสารของ Google ไม่ได้
- รุ่นน้อง "เก่งขึ้น" แค่ไหน: บล็อกของ Google ใช้คำว่าคะแนน "แข็งแรงขึ้น" และ The Decoder เขียนว่าคะแนน "สูง" เพิ่มขึ้น แต่ตารางในงานวิจัยแสดงว่าส่วนที่เพิ่มคือระดับดี ซึ่งยังไม่ชัดทางสถิติ และระดับยอดเยี่ยมไม่เพิ่ม ReadEval ยึดตามตารางในงานวิจัย
- ค่า p ของผลวันที่ 10: บทคัดย่อระบุ p = 0.03 ซึ่งมาจากแบบจำลองที่ผู้วิจัยเลือกเป็นหลัก ส่วนแบบจำลองที่ใช้คะแนนเฉลี่ยรายคนได้ p = 0.05 ขนาดผลเท่ากันที่ 0.34 SD
- การเปิดเผยทุน: งานวิจัยและหน้า NBER ระบุว่า Google ออกค่าใช้จ่ายและดำเนินการทดลอง แต่บล็อกของ Google Research ไม่ได้พูดถึงแหล่งทุน และ The Decoder บอกเพียงว่าเป็นงานที่ Google ให้ทุน
- ความแรงของคำ: หัวข่าวของ The Decoder ใช้คำว่า AI "อาจค่อย ๆ ฉุดการเติบโต" ของทนายรุ่นน้อง แต่งานวิจัยพบเพียงว่ารุ่นน้องไม่ได้ฝีมือเพิ่มโดยเฉลี่ยและคะแนนกระจายออก ไม่ได้พบว่าฝีมือเฉลี่ยลดลง
- เหตุผลของสัดส่วน 2:1: งานวิจัยบอกว่าเป็นการประนีประนอมระหว่างทีมวิจัยที่อยากแบ่งครึ่งกับสำนักงานกฎหมายที่อยากให้ทนายได้ใช้ AI เร็วขึ้น แต่หน้าทะเบียนการทดลองเขียนว่าเพื่อรองรับข้อจำกัดในการหาผู้เข้าร่วมและ "เป้าหมายการหาผู้ใช้ผลิตภัณฑ์ของ Google"
- วันที่: งานออกครั้งแรกเมื่อกันยายน 2026 ปรับปรุงเมื่อตุลาคม Google เขียนบล็อกเมื่อ 7 ต.ค. และ The Decoder รายงานเมื่อ 24 ต.ค. 2026
บทวิเคราะห์จาก ReadEval
Eva · โต๊ะวิจัยและผลทดสอบ
AI ทำให้งานวันนี้ดีขึ้นได้จริง แต่งานนี้เตือนว่างานที่ดีขึ้นไม่ได้แปลว่าคนทำเก่งขึ้นเสมอ จุดแข็งของงานคือการออกแบบ ทั้งการสุ่มแบ่งกลุ่ม ผู้ตรวจที่ไม่รู้กลุ่ม การลงทะเบียนล่วงหน้า และที่สำคัญคือการแยกวัดงานที่ทำร่วมกับ AI ออกจากงานที่ต้องทำเอง ซึ่งผู้วิจัยบอกว่ายังไม่เคยมีงานไหนทำครบแบบนี้กับคนทำงานวิชาชีพจริง ส่วนจุดที่ต้องระวังคือ Google เป็นทั้งผู้ทำ ผู้จ่าย และเจ้าของเครื่องมือ กลุ่มรุ่นน้องในงานตรวจแก้มีเพียงราว 25 คน และผลบางส่วนอ่อนลงเมื่อตัดงานที่อาจแอบใช้ AI ออก ReadEval จึงมองว่าข้อสรุปที่ว่า "รุ่นพี่ได้ฝีมือเพิ่ม รุ่นน้องไม่ได้" ยังเป็นสัญญาณที่ต้องรอการทดลองซ้ำ ไม่ใช่ข้อเท็จจริงที่ยืนยันแล้ว แต่สำหรับคนทำงานรุ่นใหม่ บทเรียนที่ใช้ได้ทันทีคือ ให้ AI ช่วยคุณคิด อย่าให้ AI คิดแทนคุณในงานที่คุณยังอยากเก่งขึ้น
แหล่งที่มา
- NBER Working Paper 35720: Does AI Assistance Enhance or Erode Expertise? (Autor et al.) หน้าบทคัดย่อและการเปิดเผยผลประโยชน์
- NBER Working Paper 35720 ฉบับเต็ม (PDF, ปรับปรุงตุลาคม 2026)
- AEA RCT Registry: AI & Expertise research with patent lawyers (AEARCTR-0015823)
- Google Research Blog: Does better work always mean better workers? (7 ต.ค. 2026)
- The Decoder: AI makes junior patent attorneys instantly better but may quietly stunt their professional growth (24 ต.ค. 2026)
- Marginal Revolution (Tyler Cowen): Does AI assistance enhance or erode expertise? (14 ก.ย. 2026)