DeepSeek แจกโมเดลรุ่นใหม่ให้โหลดไปใช้ฟรี แต่ไฟล์ใหญ่ราว 510GB คนทั่วไปลองผ่านแอปง่ายกว่า
DeepSeek-V4.1-Flash-1017 ใช้เชิงพาณิชย์ได้ภายใต้ MIT แต่ต้องใช้เครื่อง RAM 128GB ขึ้นไป ผู้วัดอิสระยืนยันว่าดีขึ้นจากรุ่นก่อน ส่วนแอปเก็บข้อมูลในจีน
สารบัญ (9 หัวข้อ)
- สรุปประเด็นสำคัญ
- open-weight และสัญญาอนุญาต MIT หมายความว่าอะไร
- ทำไมบางที่บอก 552B บางที่บอก 763B
- คอมพิวเตอร์ของฉันรันได้ไหม
- ลองใช้ฟรีได้ทางไหน
- ผลทดสอบ: ดีขึ้นจากรุ่นก่อนจริง แต่คำอ้างว่าชนะคู่แข่งต้องรอดู
- ใช้แอปหรือเว็บ DeepSeek ข้อมูลของคุณไปไหน
- สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- บทวิเคราะห์จาก ReadEval
DeepSeek บริษัท AI จากจีนที่คนไทยหลายคนรู้จักจากแอปแชตรูปวาฬสีฟ้า ไม่ได้แค่อัปเดตโมเดลในแอปของตัวเอง แต่ยังแจกตัวโมเดลรุ่นใหม่ชื่อ V4.1-Flash-1017 ให้ทุกคนดาวน์โหลดไปเก็บไว้ในเครื่องของตัวเองได้ด้วย จะใช้ส่วนตัวหรือนำไปทำธุรกิจก็ได้ โดยไม่ต้องขออนุญาตหรือจ่ายค่าใช้งานให้บริษัท
การแจกแบบนี้เรียกว่า open-weight เหมือนร้านอาหารที่แจกสูตรให้ลูกค้ากลับไปทำเองที่บ้าน แทนการขายเฉพาะอาหารที่หน้าร้าน DeepSeek ใช้สัญญาอนุญาต MIT ซึ่งเปิดกว้างมาก ขอเพียงคงข้อความลิขสิทธิ์ไว้ แต่ต่างจากสูตรอาหารตรงที่ครัวที่ต้องใช้กับสูตรนี้ใหญ่ระดับภัตตาคาร
ไฟล์ของโมเดลรวมกันราว 510GB ซึ่งต้องมีที่วางในเครื่องทั้งหมด ถึงจะใช้รุ่นที่ Unsloth ผู้ทำเครื่องมือรันโมเดลบีบอัดให้เล็กลงแล้ว เครื่องก็ยังต้องมีหน่วยความจำ (RAM) อย่างน้อย 128GB หรือ 8 เท่าของโน้ตบุ๊กทั่วไปที่มี 16GB พูดง่าย ๆ คือโมเดลนี้เปิดให้ทุกคนก็จริง แต่คนที่รันเองได้คือบริษัทหรือคนที่มีเครื่องระดับเวิร์กสเตชัน
ส่วนตัวเก่งขึ้นแค่ไหน ตัวเลขส่วนใหญ่ยังเป็นผลทดสอบที่ DeepSeek วัดเอง ข่าวดีคือ Artificial Analysis ซึ่งเป็นผู้วัดอิสระ ให้คะแนนรุ่นนี้สูงกว่ารุ่นเดือนกันยายน และพบว่าค่าใช้จ่ายต่องานลดลงเกือบครึ่ง ข่าวร้ายคือ Vals AI ซึ่งเป็นผู้วัดอิสระอีกราย วัดชุดทดสอบงานใน command line ได้ต่ำกว่าที่บริษัทประกาศอย่างเห็นได้ชัด
สำหรับคนทั่วไป ทางที่ง่ายที่สุดคือลองผ่านเว็บ chat.deepseek.com หรือแอป DeepSeek ที่ดาวน์โหลดได้ฟรี ซึ่งเปลี่ยนมาใช้โมเดลรุ่นนี้แล้ว แต่ควรรู้ว่าทุกข้อความที่พิมพ์จะถูกส่งไปเก็บและประมวลผลบนเซิร์ฟเวอร์ในจีน ตามที่นโยบายความเป็นส่วนตัวของบริษัทระบุ และอาจถูกนำไปใช้ปรับปรุงโมเดล ถ้าคุณจะใช้ อย่าใส่ข้อมูลลับหรือข้อมูลลูกค้า และถ้าใช้กับงาน ให้เช็กนโยบายขององค์กรก่อน ด้านล่างมีคำอธิบายว่าทำไมขนาดโมเดลมีทั้ง 552B และ 763B ตารางสเปกเครื่องที่ต้องใช้ ผลทดสอบเทียบผู้วัดอิสระ และวิธีปิดไม่ให้แชตถูกนำไปฝึกโมเดล
สรุปประเด็นสำคัญ
- ดาวน์โหลดได้ฟรี ใช้เชิงพาณิชย์ได้: DeepSeek เผยแพร่ DeepSeek-V4.1-Flash-1017 บน Hugging Face และ ModelScope เมื่อ 17 ต.ค. 2026 ภายใต้สัญญาอนุญาต MIT
- ตัวเลขขนาดนับคนละแบบ: แกนหลักของโมเดลมี 552B พารามิเตอร์ บวกหน่วยความจำแบบเปิดค้น (Engram) อีก 196B ส่วน 763B คือตัวเลขที่ Hugging Face นับอัตโนมัติจากทุกอย่างในไฟล์ แต่ละ token ใช้คำนวณจริงเพียง 8B–16B
- รันเองต้องใช้เครื่องใหญ่: ไฟล์ต้นฉบับราว 510GB รุ่นบีบอัดที่เล็กที่สุดของ Unsloth 233GB และต้องมี RAM รวมกับหน่วยความจำการ์ดจออย่างน้อยราว 128GB
- ผลทดสอบ: ผู้วัดอิสระยืนยันว่าดีขึ้นจากรุ่นก่อนจริง แต่คำอ้างว่าชนะโมเดลชั้นนำของคู่แข่งบางชุดทดสอบยังไม่มีใครยืนยัน
- นักพัฒนา: ผู้ที่เรียก Search และ Fetch API ผ่าน Claude Code, Codex หรือ DeepSeek Harness ใช้ได้ฟรีถึง 31 ต.ค. 2026 เวลา 23:00 น. ตามเวลาไทย
open-weight และสัญญาอนุญาต MIT หมายความว่าอะไร
โมเดลภาษาประกอบด้วยตัวเลขจำนวนมหาศาลที่เรียกว่าพารามิเตอร์ หรือน้ำหนัก (weights) ซึ่งได้มาจากการฝึก การเผยแพร่แบบ open-weight คือการแจกไฟล์ตัวเลขชุดนี้ให้ใครก็ดาวน์โหลดไปรันบนเครื่องของตัวเองได้ ต่างจากโมเดลแบบปิดที่ใช้ได้ผ่านแอปหรือ API ของบริษัทเท่านั้น ทั้งนี้ open-weight ไม่ได้แปลว่าเปิดข้อมูลหรือโค้ดที่ใช้ฝึกทั้งหมด
model card ของ DeepSeek ระบุว่าทั้ง repository และไฟล์น้ำหนักใช้สัญญาอนุญาต MIT ซึ่งอนุญาตให้ใช้ แก้ไข เผยแพร่ และขายต่อได้ โดยมีเงื่อนไขหลักเพียงต้องแนบข้อความลิขสิทธิ์และข้อความอนุญาตไปด้วย และผู้พัฒนาไม่รับประกันผลใด ๆ
รุ่น 1017 เป็น "การอัปเดตย่อย" ของ DeepSeek-V4.1-Flash ที่ออกเมื่อ 10 ก.ย. 2026 ไม่ใช่โมเดลที่ฝึกใหม่ทั้งหมด DeepSeek ระบุว่ารุ่นนี้เก่งขึ้นด้านการใช้เหตุผล การเขียนโค้ด งานแบบเอเจนต์ และงานด้านภาพ พร้อมใช้เวลาทำงานสั้นลงและตอบสั้นลง โดยใช้วิธีฝึกแบบ reinforcement learning ที่ให้โมเดลประเมินผลงานของตัวเอง (self-feedback) โมเดลนี้รับได้ทั้งข้อความและรูปภาพ และรับข้อมูลนำเข้ายาวได้ถึง 1 ล้าน token
ทำไมบางที่บอก 552B บางที่บอก 763B
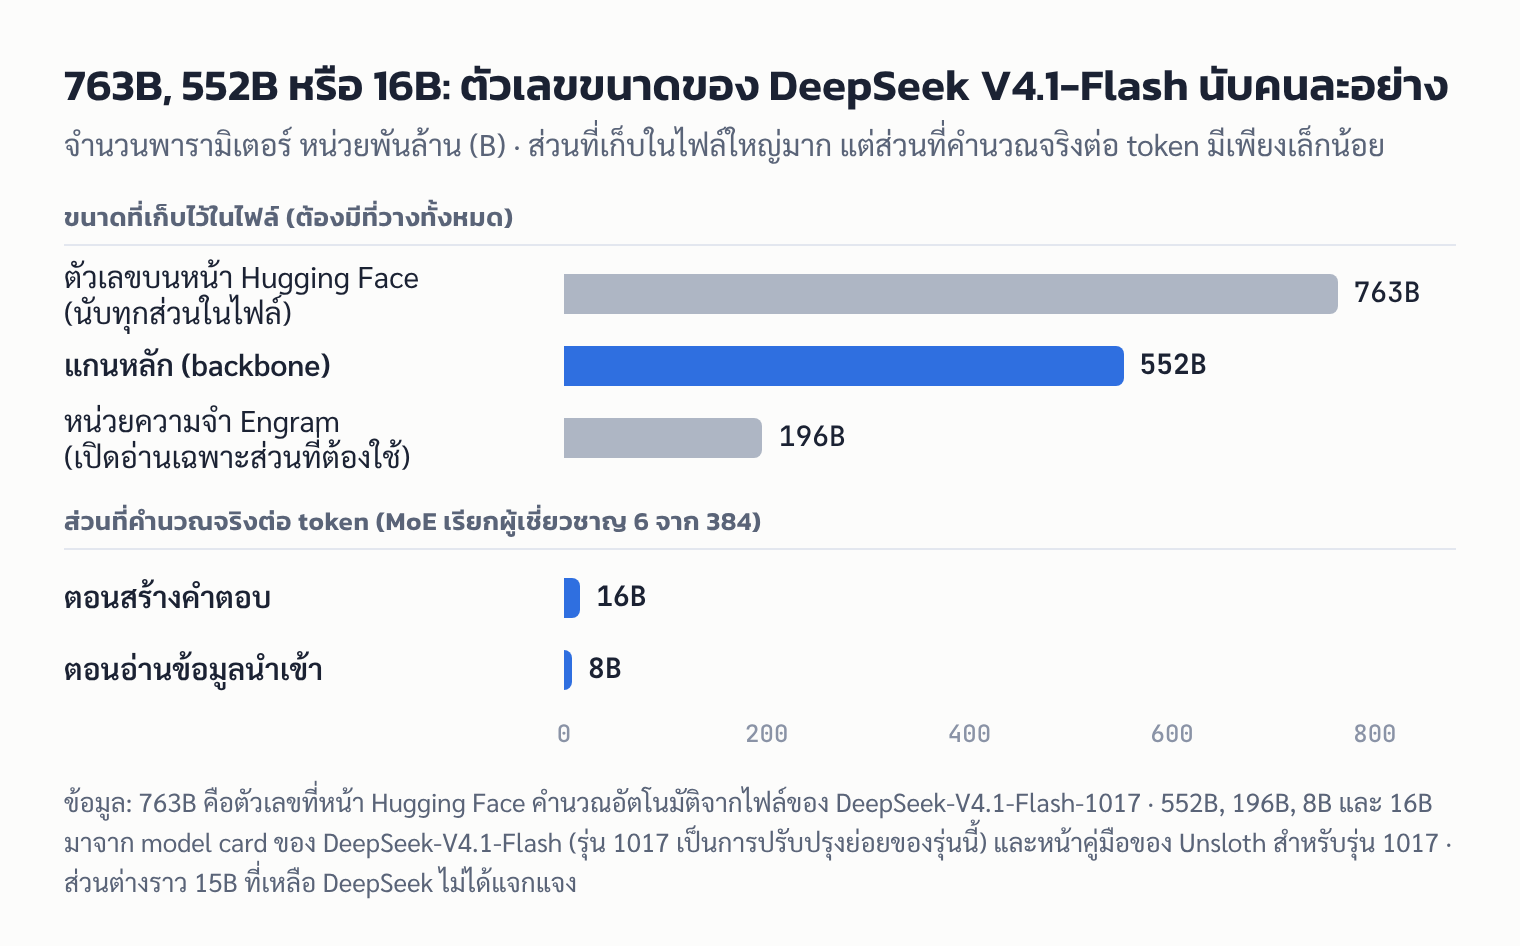
ตัวเลขที่ต่างกันไม่ได้แปลว่ามีใครผิด แต่นับกันคนละส่วน
- 552B คือแกนหลัก (backbone) ของโมเดล ตามที่ model card ของ DeepSeek-V4.1-Flash ระบุ Artificial Analysis และ Unsloth ใช้ตัวเลขนี้กับรุ่น 1017 เช่นกัน ส่วน model card ของรุ่น 1017 เองไม่ได้ระบุจำนวนพารามิเตอร์ไว้
- 196B คือส่วนที่ DeepSeek เรียกว่า Engram conditional memory นึกถึงพจนานุกรมเล่มหนาบนชั้น ที่โมเดลเปิดค้นเฉพาะหน้าที่ตรงกับคำที่กำลังอ่าน แทนการคำนวณทั้งเล่ม Unsloth ระบุว่าส่วนนี้วางไว้บน SSD แล้วดึงขึ้นมาเฉพาะแถวที่ใช้ได้ จึงช่วยประหยัด RAM แต่ยังต้องมีพื้นที่ดิสก์เต็มจำนวน
- 763B คือตัวเลขที่หน้า Hugging Face คำนวณอัตโนมัติจากไฟล์ทั้งหมดของรุ่น 1017 ซึ่งรวมทั้งแกนหลัก Engram และส่วนอื่น 552 + 196 ได้ 748B ส่วนต่างอีกราว 15B DeepSeek ไม่ได้แจกแจง ReadEval ประเมินว่าน่าจะเป็นส่วนประกอบอื่นที่อยู่ในไฟล์ เช่น ตัวอ่านภาพ (vision encoder) และชั้นที่ช่วยเดาคำล่วงหน้า (DSpark) ซึ่งปรากฏในไฟล์ตั้งค่าของโมเดล
ตัวเลขที่บอกว่าโมเดลทำงานหนักแค่ไหนจริง ๆ คือ พารามิเตอร์ที่ใช้งานจริง (active) DeepSeek-V4.1-Flash เป็นโมเดลแบบ Mixture of Experts (MoE) ทุกชั้นมี "ผู้เชี่ยวชาญ" 384 ตัว และเรียกใช้เพียง 6 ตัวต่อ token บวกผู้เชี่ยวชาญกลางอีก 1 ตัว ผลคือตอนอ่านข้อมูลนำเข้าคำนวณจริงเพียง 8B และตอนสร้างคำตอบ 16B หรือไม่ถึง 3% ของแกนหลัก นี่คือเหตุผลที่โมเดลตอบได้เร็วและคิดค่าบริการถูก แต่ไม่ได้ช่วยเรื่องพื้นที่ เพราะทุกส่วนยังต้องโหลดเตรียมไว้ในเครื่อง
คอมพิวเตอร์ของฉันรันได้ไหม
ถ้าเป็นโน้ตบุ๊กหรือคอมพิวเตอร์ตั้งโต๊ะทั่วไป คำตอบคือไม่ได้ Kaspersky ระบุไว้ในคู่มือการใช้ DeepSeek อย่างปลอดภัยว่าโน้ตบุ๊กที่มี RAM 16–32GB เหมาะกับโมเดลขนาดราว 7B–13B ซึ่งเล็กกว่ารุ่นนี้หลายสิบเท่า
| วิธีรัน | ขนาดไฟล์ | หน่วยความจำที่ต้องใช้ (RAM + การ์ดจอ) | หมายเหตุ |
|---|---|---|---|
| ไฟล์ทางการจาก DeepSeek (FP8 และ FP4) | ราว 510GB (48 ไฟล์) | ไม่ระบุ | ตัวอย่างในโค้ดอ้างอิงของ DeepSeek แบ่งโมเดลรันพร้อมกัน 8 ส่วน (โดยทั่วไปคือการ์ดจอ 8 ใบ) |
| Unsloth UD-IQ1_S (บีบอัด 1 บิต) | 233.0GB | ราว 128–145GB | Unsloth บอกว่าใช้ได้กับเครื่อง RAM 128GB เช่น MacBook, DGX Spark หรือ RTX Spark |
| Unsloth UD-Q2_K_XL (2 บิต) | 334.8GB | ราว 176–205GB | |
| Unsloth UD-IQ3_XXS (3 บิต) | 394.7GB | ราว 256–290GB | Unsloth แนะนำเครื่อง 256GB เช่น Mac Studio |
| Unsloth UD-Q4_K_XL (4 บิต) | 500.7GB | ราว 305GB | Unsloth เรียกว่า "near lossless" |
ตัวเลขหน่วยความจำของ Unsloth คิดแบบวางส่วน Engram ไว้บน SSD และอาจต้องใช้มากกว่านี้ตามความยาวของข้อมูลนำเข้า ส่วนคุณภาพของรุ่นบีบอัด Unsloth วัดว่ารุ่น 1 บิต (UD-IQ1_M) เลือกคำถัดไปตรงกับต้นฉบับ 87.1–88.2% ขณะที่รุ่น 4 บิตตรง 98.2–98.5% ตัวเลขนี้วัดความเหมือนต้นฉบับ ไม่ใช่คะแนนความเก่ง
ข้อควรรู้อีกข้อคือ ตอนนี้ยังไม่ใช่การติดตั้งแบบคลิกเดียว หน้าคู่มือของ Unsloth ให้ดาวน์โหลดโค้ดของ llama.cpp จาก pull request เฉพาะ (หมายเลข 30817) มาคอมไพล์เอง และไม่ได้พูดถึง Ollama หรือ LM Studio ReadEval ยังไม่ได้ยืนยันว่าสองโปรแกรมนี้รองรับรุ่นนี้แล้วหรือยัง
ลองใช้ฟรีได้ทางไหน
บนเว็บ
- เข้า chat.deepseek.com แล้วล็อกอินหรือสมัครบัญชี
- พิมพ์คำถามได้ทันที หน้าเว็บของ DeepSeek ระบุว่าเว็บและแอปเปลี่ยนมาใช้รุ่น 1017 แล้ว
บนมือถือ
- ค้นหา DeepSeek ใน App Store หรือ Google Play
- ตรวจชื่อผู้พัฒนาให้เป็น Hangzhou DeepSeek Artificial Intelligence Co., Ltd ตามที่หน้า App Store ประเทศไทยแสดง (ตรวจเมื่อ 26 ต.ค. 2026) เพื่อเลี่ยงแอปปลอม หน้านี้แสดงว่าแอปดาวน์โหลดได้ฟรี
สำหรับนักพัฒนา (API)
ใช้ชื่อโมเดล deepseek-flash ซึ่งตอนนี้ทำงานด้วยรุ่น 1017 ราคาตามหน้าราคาของ DeepSeek เป็นดังนี้
| รายการ | ช่วงเวลาปกติ | ช่วงคนใช้น้อย (off-peak) |
|---|---|---|
| ข้อมูลนำเข้า (cache miss) ต่อ 1 ล้าน token | 0.30 ดอลลาร์ | 0.15 ดอลลาร์ |
| ข้อมูลนำเข้า (cache hit) ต่อ 1 ล้าน token | 0.006 ดอลลาร์ | 0.003 ดอลลาร์ |
| คำตอบ ต่อ 1 ล้าน token | 1.20 ดอลลาร์ | 0.60 ดอลลาร์ |
ช่วงราคาปกติคือ 01:00–04:00 และ 06:00–10:00 น. UTC วันจันทร์ถึงศุกร์ หรือ 08:00–11:00 และ 13:00–17:00 น. ตามเวลาไทย ไม่นับวันหยุดราชการของจีน ช่วงเวลาอื่นทั้งหมดรวมเสาร์อาทิตย์คิดราคาครึ่งเดียว
DeepSeek ยังเปิด Search และ Fetch API ซึ่งให้โปรแกรมค้นเว็บและดึงเนื้อหาหน้าเว็บผ่านเสิร์ชเอนจินของบริษัทเอง ราคา 0.75 ดอลลาร์ต่อ 1,000 ครั้งที่สำเร็จ ถ้าเรียกผ่านเครื่องมือฝั่งเซิร์ฟเวอร์ใน DeepSeek Harness, Claude Code หรือ Codex จะยังไม่คิดเงินจนถึง 31 ต.ค. 2026 เวลา 16:00 น. UTC (23:00 น. ตามเวลาไทย) ควรระวังว่าเมื่อตั้ง Claude Code หรือ Codex ให้ใช้ DeepSeek API โค้ดและคำสั่งที่ส่งให้โมเดลจะไปประมวลผลบนเซิร์ฟเวอร์ของ DeepSeek
ผลทดสอบ: ดีขึ้นจากรุ่นก่อนจริง แต่คำอ้างว่าชนะคู่แข่งต้องรอดู
ตารางด้านล่างคัดมาจาก model card ของรุ่น 1017 ซึ่ง DeepSeek วัดเองทั้งหมด
| ชุดทดสอบ | V4.1-Flash-1017 | V4.1-Flash (ก.ย.) | Opus 5 | GPT-5.6 Sol | K3 | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 | 51.8 | 39.9 | 12.6 | 37.9 |
| DeepSWE v1.1 | 77.0 | 74.2 | 74.0 | 73.0 | 67.5 | 66.9 |
| ProgramBench | 29.1 | 20.3 | 37.0 | 23.0 | 17.5 | 19.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 75.3 | 56.8 | 58.0 | 58.0 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 50.3 | 45.8 | 46.7 | 48.8 |
| HLE (ไม่ใช้เครื่องมือ) | 42.6 | 36.8 | 56.3 | 44.5 | 43.5 | 42.0 † |
ยิ่งสูงยิ่งดี · † วัดเฉพาะโจทย์ที่เป็นข้อความ · DeepSeek ระบุว่าใช้ Claude Code เป็นตัวควบคุมการทดสอบ (harness) สำหรับ Terminal-Bench 4.0 และ Mini-SWE-V2 สำหรับ DeepSWE v1.1
จากตารางจะเห็นว่ารุ่น 1017 ดีขึ้นจากรุ่นเดือนกันยายนทุกแถว และชนะทุกคู่แข่งใน DeepSWE กับ Automation-Bench แต่ยังตาม Opus 5 ในชุดทดสอบส่วนใหญ่ DeepSeek ยังเผยแพร่กราฟที่อ้างว่ารุ่นนี้ได้ 77.0% บน DeepSWE ด้วยค่าใช้จ่ายเฉลี่ยไม่ถึง 0.20 ดอลลาร์ต่องาน และได้มากกว่า 72% ที่ราว 0.10 ดอลลาร์ต่องานเมื่อตั้งระดับการคิดต่ำ ตาม The Decoder รายงาน
ข้อควรระวังจากการอ่านตารางเอง
- Terminal-Bench 4.0 ไม่ได้วัดแบบเดียวกัน: model card ของรุ่นเดือนกันยายนระบุว่าวัดชุดทดสอบเขียนโค้ดด้วย DeepSeek Harness ของบริษัทเอง แต่รุ่น 1017 วัดด้วย Claude Code การกระโดดจาก 31.2 เป็น 42.3 จึงอาจมาจากทั้งตัวโมเดลและตัวควบคุมการทดสอบที่เปลี่ยน
- ตัวเลขของคู่แข่งเป็นชุดเดิม: คะแนนของ Opus 5, GPT-5.6 Sol, K3 และ GLM-5.3 ในตารางนี้ตรงกับตารางที่ DeepSeek ใช้ตอนเปิดตัวรุ่นเดือนกันยายนทุกตัว จึงไม่ได้วัดใหม่พร้อมกัน
- ตัวเลขรุ่นก่อนไม่ตรงกันเอง: NL2Repo-Bench ของรุ่นเดือนกันยายนเป็น 64.0 ใน model card เดิม แต่เป็น 65.4 ใน model card ของรุ่น 1017
ผู้วัดอิสระพบอะไร
| ผู้วัด | สิ่งที่วัด | V4.1-Flash (ก.ย.) | V4.1-Flash-1017 |
|---|---|---|---|
| Artificial Analysis | Intelligence Index (ค่ามัธยฐานของโมเดลกลุ่มเดียวกัน 19) | 39 | 45 |
| Artificial Analysis | ค่าใช้จ่ายต่องานในการทดสอบชุดนี้ | 0.48 ดอลลาร์ | 0.26 ดอลลาร์ |
| Artificial Analysis | token ที่ตอบออกมาตลอดการทดสอบ (มัธยฐาน 140 ล้าน) | 250 ล้าน | 210 ล้าน |
| Artificial Analysis | ความเร็วในการตอบ | 177.8 token/วินาที | 167.3 token/วินาที |
| Vals AI | Terminal-Bench 4.0 | ไม่มีข้อมูล | 31.82% (±2.62) อันดับ 19 จาก 55 |
| Vals AI | Vals Index | ไม่มีข้อมูล | 61.26% อันดับ 9 จาก 27 |
ผลของ Artificial Analysis สนับสนุนคำอ้างหลักของ DeepSeek ว่ารุ่นใหม่เก่งขึ้น ตอบสั้นลง และถูกลงต่องาน แม้ยังถูกจัดว่า "ตอบยาวมาก" เมื่อเทียบกับโมเดลอื่น ส่วน Terminal-Bench 4.0 ที่ Vals AI วัดได้ 31.82% ต่ำกว่าตัวเลข 42.3 ที่ DeepSeek รายงานราว 10 จุด หน้าของ Vals AI ไม่ได้ระบุว่าใช้ harness ตัวไหน จึงยังสรุปไม่ได้ว่าความต่างมาจากอะไร
ระดับความน่าเชื่อถือของตัวเลขชุดนี้: 🟡 พอใช้อ้างอิงได้ (3 จาก 6) ReadEval ให้ผ่านข้อทำซ้ำได้ (โมเดลเปิด ชุดทดสอบเป็นของสาธารณะ และระบุ harness) ข้อบอกสภาพแวดล้อม (ระบุค่าการสุ่มและความยาว context) และข้อความเป็นอิสระ (มีผู้วัดอิสระยืนยันทิศทางว่าดีขึ้นจากรุ่นก่อน) แต่ไม่ผ่านข้อรายงานความแปรปรวน ข้อเทียบอย่างยุติธรรม (ใช้ตัวเลขคู่แข่งชุดเดิมและเปลี่ยน harness) และข้อยอมรับข้อจำกัด
ใช้แอปหรือเว็บ DeepSeek ข้อมูลของคุณไปไหน
นโยบายความเป็นส่วนตัวของ DeepSeek (ปรับปรุงล่าสุด 10 ก.พ. 2026) ระบุประเด็นหลักไว้ดังนี้
- ผู้ควบคุมข้อมูล: Hangzhou DeepSeek Artificial Intelligence Co., Ltd. บริษัทที่จดทะเบียนในจีน
- ข้อมูลที่เก็บ: ข้อความ เสียง ไฟล์และรูปที่อัปโหลด ประวัติแชต รวมถึงข้อมูลบัญชี เช่น อีเมลหรือเบอร์โทรศัพท์
- ที่เก็บข้อมูล: "เราเก็บรวบรวม ประมวลผล และจัดเก็บข้อมูลส่วนบุคคลของคุณโดยตรงในสาธารณรัฐประชาชนจีน"
- การนำไปฝึกโมเดล: ใช้ข้อมูลเพื่อ "ฝึกและปรับปรุงเทคโนโลยี" รวมถึงโมเดล machine learning ส่วนเอกสารอธิบายวิธีฝึกโมเดลของบริษัทระบุว่าข้อมูลฝึกบางส่วน "อาจมาจากข้อมูลที่ผู้ใช้ป้อน" โดยผ่านการเข้ารหัสและลบข้อมูลที่ระบุตัวตนก่อน
- สิทธิ์ของผู้ใช้: มีสิทธิ์ขอไม่ให้นำข้อมูลไปฝึกโมเดล ขอดู แก้ไข หรือลบข้อมูล ผ่านอีเมล privacy@deepseek.com
- การส่งต่อให้หน่วยงานรัฐ: อาจเปิดเผยข้อมูลแก่หน่วยงานบังคับใช้กฎหมายหรือหน่วยงานรัฐเมื่อเชื่อว่าจำเป็นต้องทำตามกฎหมายหรือคำขอของรัฐ
ในหลักการ แชตบอตบนคลาวด์ทุกเจ้าต้องส่งข้อความไปประมวลผลที่เซิร์ฟเวอร์ของผู้ให้บริการ และ Kaspersky ก็ชี้ว่า ChatGPT และ Gemini ส่งข้อมูลผู้ใช้ให้เจ้าหน้าที่ตามคำขอได้เช่นกัน สิ่งที่ต่างคือกฎหมายที่ใช้บังคับ Kaspersky ระบุว่า DeepSeek อยู่ภายใต้กฎหมายจีน หน่วยงานบังคับใช้กฎหมายของจีนจึงอาจขอเข้าถึงแชตได้ตามที่กฎหมายท้องถิ่นกำหนด สำหรับคนไทย ReadEval ยังไม่ได้ตรวจว่ามีหน่วยงานรัฐไทยออกข้อห้ามใช้ DeepSeek หรือไม่ ถ้าคุณใช้กับงาน ให้ถามฝ่ายไอทีหรือดูนโยบายขององค์กรก่อน
วิธีปิดไม่ให้แชตถูกนำไปฝึกโมเดล (ตามคู่มือของ Kaspersky เดือนตุลาคม 2025 ชื่อเมนูอาจเปลี่ยนไปแล้ว)
- บนเว็บ: เปิดแถบด้านซ้าย คลิกจุดสามจุดข้างชื่อของคุณด้านล่าง เลือก Settings ไปที่แท็บ Data แล้วปิด "Improve the model for everyone"
- บนแอป: เปิดแถบด้านซ้าย แตะจุดสามจุดข้างชื่อ เลือก Settings ไปที่ Data controls แล้วปิด "Improve the model for everyone"
- การปิดตัวเลือกนี้ไม่ย้อนกลับไปถึงแชตที่ส่งไปแล้ว ถ้าต้องการให้หยุดใช้ข้อมูลเก่า Kaspersky แนะนำให้อีเมลถึง privacy@deepseek.com และระบุแชตหรือข้อมูลที่ต้องการ
- การลบแชตในแอปทำได้ที่ Settings > Data (เว็บ) หรือ Data controls (แอป) > Delete all chats แต่ Kaspersky ระบุว่าการลบแชตออกจากบัญชีไม่ได้ลบข้อมูลออกจากเซิร์ฟเวอร์ของ DeepSeek
ถ้ารันในเครื่องเอง ข้อความที่พิมพ์จะไม่ถูกส่งไปที่ DeepSeek เลย เพราะโมเดลทำงานบนเครื่องของคุณ แต่ต้องแลกกับฮาร์ดแวร์ราคาสูงตามตารางด้านบน และ Kaspersky เตือนว่าโมเดลที่รันในเครื่องค้นข้อมูลล่าสุดจากอินเทอร์เน็ตไม่ได้ นอกจากต่อเครื่องมือค้นหาเพิ่มเอง
สิ่งที่แหล่งข่าวรายงานไม่ตรงกัน
- จำนวนพารามิเตอร์: 552B (DeepSeek, Artificial Analysis, Unsloth) กับ 763B (ตัวนับอัตโนมัติของ Hugging Face) นับคนละส่วนตามที่อธิบายด้านบน ReadEval ใช้ 552B ตามแหล่งต้นทางคือ DeepSeek และระบุ Engram 196B แยกไว้
- Terminal-Bench 4.0: DeepSeek รายงาน 42.3 (ใช้ Claude Code) ส่วน Vals AI วัดได้ 31.82
- ราคา API: ถ้าเห็นราคาข้อมูลนำเข้า 0.15 ดอลลาร์ในบางแห่ง และ 0.30 ดอลลาร์ต่อ 1 ล้าน token ในอีกแห่ง ทั้งสองตัวเลขถูก เพราะเป็นราคาช่วงคนใช้น้อยกับช่วงปกติตามหน้าราคาของ DeepSeek
- ราคา Search API: หน้าราคาภาษาอังกฤษของ DeepSeek ระบุ 0.75 ดอลลาร์ต่อ 1,000 ครั้ง ส่วน TechNews ของไต้หวันรายงาน 5 หยวนต่อ 1,000 ครั้ง ReadEval ยึดหน้าราคาภาษาอังกฤษ ตัวเลขหยวนน่าจะเป็นราคาสำหรับแพลตฟอร์มในจีน
- วันหมดช่วงใช้ฟรี: ประกาศของ DeepSeek ระบุ 31 ต.ค. 2026 เวลา 16:00 น. UTC ส่วนหน้าราคาระบุ 00:00 น. วันที่ 1 พ.ย. ตามเวลาปักกิ่ง ซึ่งเป็นเวลาเดียวกัน
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
โมเดลนี้เปิดจริงและเก่งขึ้นจริง แต่สำหรับคนทั่วไป "ดาวน์โหลดฟรี" ยังไม่ได้แปลว่า "รันเองได้" DeepSeek-V4.1-Flash-1017 เป็นโมเดลแบบเปิดที่ควรจับตา เพราะผู้วัดอิสระอย่าง Artificial Analysis ยืนยันว่าเก่งขึ้นและถูกลงต่องานจากรุ่นก่อน ส่วนสัญญาอนุญาต MIT ก็เปิดให้บริษัทนำไปให้บริการบนเซิร์ฟเวอร์ของตัวเองได้ ซึ่งเป็นทางเลือกสำหรับองค์กรที่อยากใช้ความสามารถระดับนี้โดยไม่ส่งข้อมูลไปที่ DeepSeek ส่วนคำอ้างว่าชนะโมเดลชั้นนำของคู่แข่ง ยังควรอ่านอย่างระวัง เพราะใช้ตัวเลขคู่แข่งชุดเดิมและเปลี่ยนวิธีวัดบางชุด และผลของ Vals AI ก็ต่ำกว่าที่บริษัทประกาศ สำหรับผู้ใช้ทั่วไป ReadEval ประเมินว่าการลองผ่านแอปหรือเว็บกับเรื่องทั่วไปไม่ใช่เรื่องที่ต้องกังวลเกินเหตุ ตราบใดที่คุณรู้ว่าข้อมูลถูกเก็บในจีนภายใต้กฎหมายจีน ปิดตัวเลือกนำแชตไปฝึกโมเดล และไม่ใส่ข้อมูลที่ไม่อยากให้ใครเห็น ส่วนใครอยากรู้ว่าโมเดลแบบเปิดที่รันบนโน้ตบุ๊กได้จริงหน้าตาเป็นอย่างไร อ่านเทียบได้ที่ข่าว Flint ของ Recursive ที่ ReadEval เคยอธิบายไว้
แหล่งที่มา
- Hugging Face: model card ของ DeepSeek-V4.1-Flash-1017 (รวมไฟล์ config, LICENSE และข้อมูลไฟล์)
- Hugging Face: model card ของ DeepSeek-V4.1-Flash (รุ่นเดือนกันยายน)
- DeepSeek: DeepSeek-V4.1-Flash-1017 release
- DeepSeek API: Models & Pricing
- DeepSeek API: Your First API Call
- DeepSeek: หน้าแรก (ประกาศอัปเดตเว็บและแอป)
- DeepSeek Privacy Policy (10 ก.พ. 2026)
- DeepSeek: Model Mechanism and Training Methods
- The Decoder: DeepSeek-V4.1-Flash-1017 beats larger rivals in agentic tasks
- Artificial Analysis: DeepSeek V4.1 Flash 1017
- Artificial Analysis: DeepSeek V4.1 Flash (รุ่นเดือนกันยายน)
- Vals AI: DeepSeek V4.1 Flash 1017
- Unsloth: DeepSeek-V4.1-Flash-1017 GGUF guide
- Runtime Wire: Unsloth fits DeepSeek's 552B model into a 250GB local download
- TechNews 科技新報: DeepSeek 推全新 V4.1-Flash 模型
- Kaspersky: DeepSeek: configuring privacy and deploying a local version
- App Store ประเทศไทย: DeepSeek - AI Assistant