OpenAI จะซ่อนลายน้ำในคำที่ ChatGPT เลือกใช้ในยุโรป แต่แค่เปลี่ยนคำบางส่วนก็ตรวจยากขึ้น
OpenAI จะฝังลายน้ำล่องหน textGrain ในข้อความ ChatGPT และ Codex ของผู้ใช้ในสหภาพยุโรปตาม AI Act แต่ผลทดสอบของบริษัทเองชี้ว่าเปลี่ยนคำ 10% ก็ตรวจเจอลดลงชัด
สารบัญ (9 หัวข้อ)
ลองนึกภาพว่าคุณให้ ChatGPT ช่วยร่างรายงาน แล้วก๊อปข้อความไปวางในไฟล์งาน ข้อความดูธรรมดาทุกอย่าง ไม่มีโลโก้ ไม่มีอักขระแปลก ๆ ซ่อนอยู่ แต่อีกไม่กี่สัปดาห์ ข้อความแบบนี้ที่สร้างในสหภาพยุโรปจะมี "ลายน้ำ" ติดไปด้วยทุกที่ที่ถูกวาง เพราะลายน้ำไม่ได้อยู่ที่ตัวอักษรตัวใด แต่ซ่อนอยู่ในการเลือกคำของทั้งย่อหน้า
OpenAI ประกาศว่าจะฝังลายน้ำล่องหนชื่อ textGrain ลงในข้อความจาก ChatGPT และผู้ช่วยเขียนโค้ด Codex ของผู้ใช้ในสหภาพยุโรปทุกแพ็กเกจ เพื่อทำตามกฎหมาย AI Act ที่บังคับให้ผู้ให้บริการ AI ทำเครื่องหมายบนงานที่ AI สร้าง ให้เครื่องตรวจได้ว่ามาจาก AI
วิธีทำงานคล้ายนักเขียนที่ตกลงรหัสกับเพื่อนไว้ ทุกครั้งที่มีหลายคำให้เลือกได้พอ ๆ กัน เช่น "เช้านี้อากาศ___" จะเติมว่าอุ่น เย็น หรือสดใสก็ได้ เขาจะเลือกตามสมุดรหัสลับ คนอ่านไม่สังเกตอะไร แต่เพื่อนที่ถือสมุดรหัสนับได้ว่าคำที่เลือกตรงกับสมุดบ่อยเกินกว่าจะบังเอิญหรือไม่ ต่างกันตรงที่ไม่มีคำไหนเป็นหลักฐานได้ด้วยตัวเอง ตัวตรวจต้องดูข้อความที่ยาวพอแล้วตอบเป็นความน่าจะเป็น ไม่ใช่คำตัดสิน และตอนนี้มีแค่ OpenAI กับนักวิจัยที่ได้รับอนุมัติเท่านั้นที่ใช้ตัวตรวจได้
ปัญหาคือลายน้ำแบบนี้ลบง่าย ผลทดสอบของ OpenAI เองพบว่า ถ้าเปลี่ยนคำเป็นคำพ้องความหมายเพียง 10% หรือราว 1 คำในทุก 10 คำ อัตราที่ตรวจเจอลดจากราว 92% เหลือ 66% แปลว่าข้อความที่มีลายน้ำหลุดรอดไปราว 1 ใน 3 ส่วนข้อความสั้น คำตอบคณิตศาสตร์ และข้อความที่แปลภาษาก็ตรวจยากขึ้นอีก OpenAI จึงเขียนเองว่า "การไม่พบลายน้ำไม่ได้พิสูจน์ว่ามนุษย์เขียน"
สำหรับคนไทย ChatGPT ที่คุณใช้อยู่ไม่ได้อยู่ในรอบนี้ เพราะ OpenAI ระบุเฉพาะผู้ใช้ในสหภาพยุโรป แต่เรื่องนี้บอกทิศทางที่ควรรู้ ถ้าคุณเป็นครูหรือหัวหน้างาน ลายน้ำไม่ใช่เครื่องจับโกง ผล "ไม่เจอ" ไม่ได้แปลว่าคนเขียนเอง และผล "เจอ" ก็ไม่ได้บอกว่าใครเป็นคนสั่ง ส่วนวิธีทำงานแบบละเอียด ตัวเลขทั้งชุด เหตุผลทางกฎหมาย และจุดที่สื่อรายงานไม่ตรงกันอยู่ด้านล่าง
สรุปประเด็นสำคัญ
- เฉพาะสหภาพยุโรป: OpenAI ประกาศเมื่อ 5 ต.ค. 2026 ว่า "ในอีกไม่กี่สัปดาห์" จะเพิ่มลายน้ำล่องหนในข้อความจาก ChatGPT และ Codex ที่ "เข้าเกณฑ์" ของผู้ใช้ในสหภาพยุโรปทุกแพ็กเกจ ส่วนนักพัฒนาที่ใช้ API ทั่วโลกเลือกเปิดเองได้ (ค่าเริ่มต้นปิด)
- ซ่อนในการเลือกคำ: textGrain ไม่เติมอักขระล่องหนหรือช่องว่างพิเศษ แต่เอียงการเลือกคำของโมเดลให้เกิดรูปแบบทางสถิติที่ตัวตรวจซึ่งถือรหัสลับเท่านั้นทดสอบได้
- แก้คำนิดเดียวก็อ่อนลง: ตามผลทดสอบของ OpenAI เปลี่ยนคำ 10% ทำให้ตรวจเจอลดจากราว 92% เหลือ 66% และเปลี่ยน 25% เหลือราว 17%
- ตัวตรวจยังไม่เปิดให้ทุกคน: ช่วงแรกเปิดให้เฉพาะนักวิจัยและองค์กรผู้เชี่ยวชาญที่ได้รับอนุมัติ คนทั่วไปและครูยังตรวจเองไม่ได้
ลายน้ำซ่อนอยู่ในคำได้อย่างไร
โมเดลภาษาเขียนข้อความทีละโทเค็น (token) ซึ่งเป็นหน่วยย่อยของข้อความ อาจเป็นคำหรือส่วนของคำ ในแต่ละตำแหน่ง โมเดลมีรายการคำที่เป็นไปได้พร้อมโอกาสของแต่ละคำ แล้วสุ่มเลือกตามโอกาสนั้น ลายน้ำแบบนี้แทรกตัวตรงจังหวะสุ่ม โดยใช้ตัวเลขสุ่มเทียมที่คำนวณจากรหัสลับ (secret key) ร่วมกับคำไม่กี่คำก่อนหน้า
รายงานทางเทคนิคของ textGrain ลงวันที่ 5 ต.ค. 2026 เขียนร่วมกันโดยนักวิจัยจาก University of Pennsylvania, Yale University และ OpenAI อธิบายขั้นตอนไว้ดังนี้ (สรุปโดย ReadEval)
- รหัสลับกับคำก่อนหน้าแบ่งคำที่เป็นไปได้ออกเป็นกลุ่ม ตัวอย่างในรายงานคือประโยค "The morning was ___" ที่คำอย่าง warm, calm, cold, sunny, mild, bright ถูกจับเป็นกลุ่มละ 2 คำ
- ระบบคำนวณว่าจะให้น้ำหนักกลุ่มไหนมากขึ้น โดยมี "งบ" จำกัดว่าห้ามลดความหลากหลายของการสุ่มเกินที่ตั้งไว้ เพื่อไม่ให้คำตอบแข็งหรือซ้ำกันทุกครั้ง
- โมเดลเลือกคำในกลุ่มนั้นตามโอกาสเดิมของคำ
ฝั่งตัวตรวจไม่ต้องใช้โมเดล รายงานระบุว่าต้องการแค่ข้อความและรหัสลับ ตัวตรวจคำนวณย้อนว่าแต่ละคำตรงกับกลุ่มที่ได้เปรียบบ่อยแค่ไหน แล้วรวมเป็นคะแนนเดียว ถ้าคะแนนสูงเกินกว่าที่ข้อความทั่วไปจะทำได้ จึงถือว่าพบลายน้ำ ตัวตรวจถูกตั้งให้ทักข้อความที่ไม่มีลายน้ำผิดไม่เกินราว 1% ตามที่ The Register และ The Next Web รายงาน
เพราะลายน้ำอยู่ในคำ ไม่ได้อยู่ในไฟล์ จึงติดไปกับการก๊อปและวาง BleepingComputer ระบุว่าไม่ใช่การเติมอักขระที่มองไม่เห็นหรือเครื่องหมายแปลก ๆ ส่วนผลต่อคุณภาพ OpenAI บอกว่าแทบไม่ต่าง Techzine ยกตัวอย่างคะแนน GPQA Diamond ของ GPT-6 Astra ที่ได้ 94.44% เมื่อเปิดลายน้ำ และ 93.94% เมื่อปิด OpenAI ยังอ้างว่า textGrain ทำได้เท่าหรือดีกว่าวิธีอื่นที่ทดสอบ รวมถึง SynthID สำหรับข้อความของ Google และวางแผนจะเปิดเป็นโอเพนซอร์สในอนาคตโดยยังไม่บอกกำหนด
ลายน้ำบนภาพ วิดีโอ และเสียงทำงานต่างออกไปและมีเครื่องมือให้คนทั่วไปตรวจได้แล้ว ReadEval อธิบายไว้ในข่าว Google เปิดเว็บ SynthID ให้ทุกคนเช็กภาพและคลิป AI
ตรวจเจอได้แค่ไหน
ตัวเลขทั้งหมดในส่วนนี้มาจากการทดสอบของ OpenAI เอง ตามที่สื่อหลายสำนักรายงานจากบล็อกของบริษัท ReadEval เปิดบล็อกของ OpenAI โดยตรงไม่ได้ (เว็บปฏิเสธการเข้าถึง) และรายงานทางเทคนิคไม่มีตัวเลขชุดนี้
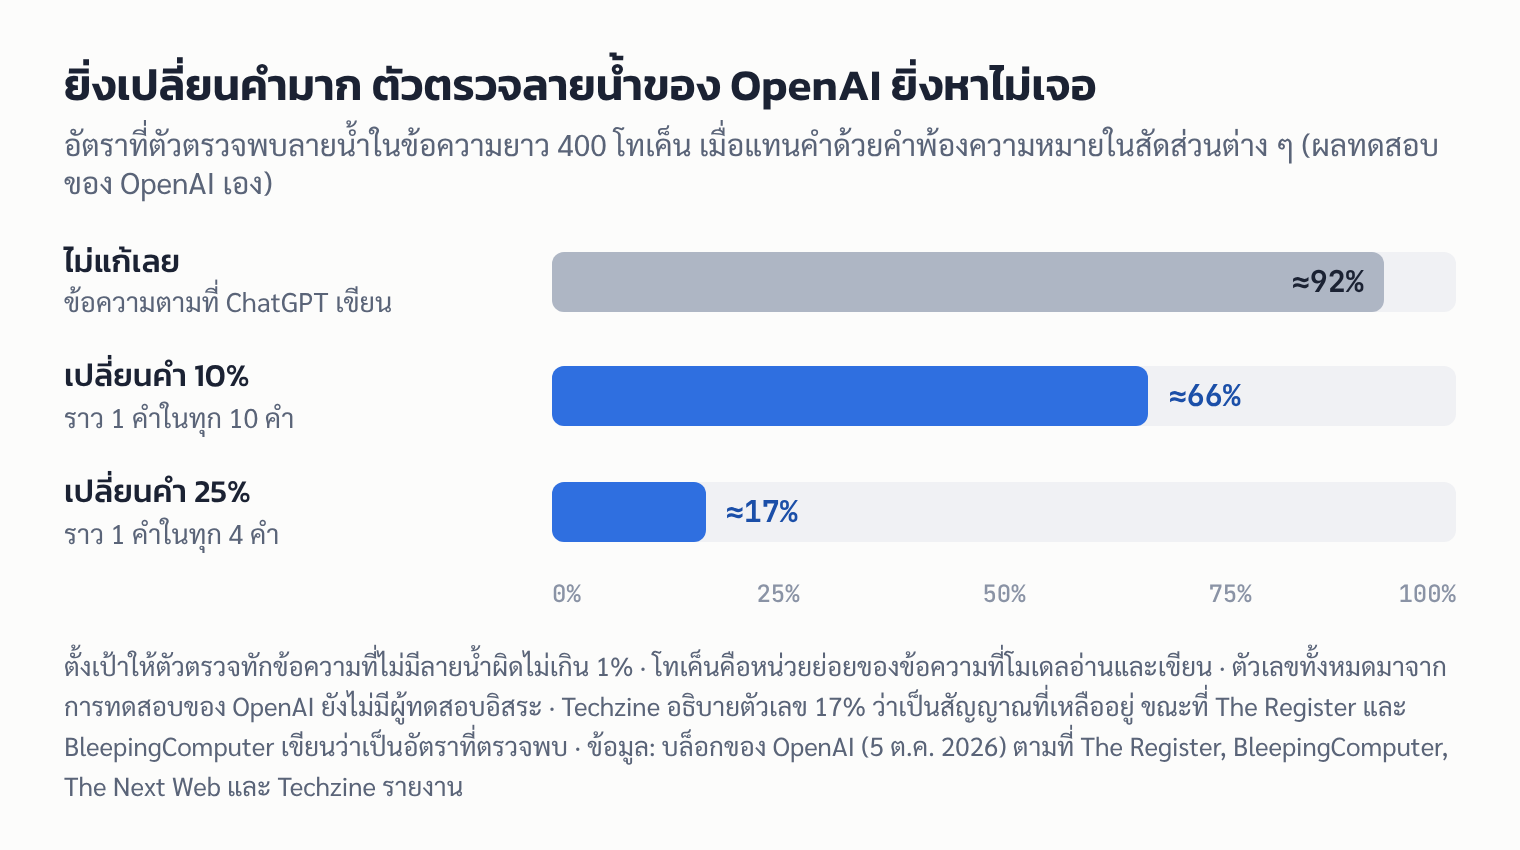
| สถานการณ์ (ตั้งเป้าทักผิดไม่เกิน 1%) | ตรวจเจอ |
|---|---|
| คำตอบเรื่องจิตวิทยา ยาว 200 โทเค็น ไม่แก้ | ราว 80% |
| คำตอบเรื่องจิตวิทยา ยาว 400 โทเค็น ไม่แก้ | ราว 95% |
| ชุดทดสอบการแก้คำ ยาว 400 โทเค็น ก่อนแก้ | ราว 92% |
| ยาว 400 โทเค็น เปลี่ยนคำพ้องความหมาย 10% | ราว 66% |
| ยาว 400 โทเค็น เปลี่ยนคำพ้องความหมาย 25% | ราว 17% |
| คำตอบคณิตศาสตร์ | ต่ำกว่ามาก (ไม่ได้ให้ตัวเลข) |
ข้อความยิ่งยาว ลายน้ำยิ่งชัด เพราะตัวตรวจมีคำให้นับมากขึ้น คณิตศาสตร์และโค้ดตรวจยากเพราะคำตอบที่ถูกมีทางเลือกคำน้อย โมเดลจึงแทบไม่มีที่ให้ซ่อนลายน้ำ The Register ชี้อีกด้านว่าการแทนคำในงานเชิงเทคนิคมีโอกาสทำให้ผิดมากกว่า
ข้อความยาว 400 โทเค็นที่ไม่ได้แก้มีตัวเลขสองค่าเพราะมาจากการทดสอบสองชุด ราว 95% มาจากชุดคำตอบเรื่องจิตวิทยาที่วัดตามความยาว ส่วนราว 92% เป็นจุดเริ่มของชุดทดสอบการแก้คำ สื่อที่รายงานไม่ได้บอกว่าสองชุดใช้ข้อความต่างกันอย่างไร
ลายน้ำบอกอะไรได้ และบอกอะไรไม่ได้
| บอกได้ | บอกไม่ได้ |
|---|---|
| ข้อความนี้น่าจะมาจากโมเดลของ OpenAI ที่เปิดลายน้ำ | ใครเป็นคนสั่ง ใช้บัญชีไหน พิมพ์ prompt อะไร หรือคุยในแชตไหน |
| คนเขียนหรือแก้เองไปมากน้อยแค่ไหน | |
| ใครเป็นเจ้าของงาน และเนื้อหาถูกต้องหรือไม่ | |
| ข้อความจาก AI ค่ายอื่น หรือจาก ChatGPT ที่ไม่ได้เปิดลายน้ำ |
ข้อนี้สำคัญกับคนที่ใช้ AI ช่วยเกลางาน Techzine รายงานว่าข้อความที่คนเขียนเองแล้วให้โมเดลพิสูจน์อักษรหรือเรียบเรียงใหม่ก็ยังมีลายน้ำได้ ซึ่งสอดคล้องกับหลักการทำงาน เพราะทุกคำที่โมเดลเขียนออกมาใหม่ผ่านการเลือกคำแบบเดียวกัน ผล "เจอลายน้ำ" จึงไม่ได้แยกว่า AI เขียนทั้งหมด หรือแค่ช่วยเกลา
ฝั่งกฎหมายเองก็มีข้อยกเว้นสำหรับระบบที่ "ทำหน้าที่ช่วยแก้ไขทั่วไป" หรือไม่ได้เปลี่ยนสิ่งที่ผู้ใช้ป้อนเข้าไปอย่างมีนัยสำคัญ แต่ไม่มีแหล่งใดที่ ReadEval พบระบุว่า OpenAI ใช้ข้อยกเว้นนี้อย่างไร และคำว่าข้อความที่ "เข้าเกณฑ์" ก็ยังไม่ถูกนิยามในรายงานของสื่อ
ทำไมเฉพาะยุโรป
ต้นเหตุคือมาตรา 50 วรรค 2 ของ AI Act (Regulation (EU) 2024/1689) ซึ่งหน้า AI Act Service Desk ของคณะกรรมาธิการยุโรปเผยแพร่ไว้ ใจความคือ ผู้ให้บริการระบบ AI รวมถึง AI อเนกประสงค์ ที่สร้างเสียง ภาพ วิดีโอ หรือข้อความสังเคราะห์ ต้องทำให้ผลลัพธ์ "ถูกทำเครื่องหมายในรูปแบบที่เครื่องอ่านได้ และตรวจได้ว่าสร้างหรือดัดแปลงด้วย AI" และวิธีที่ใช้ต้อง "มีประสิทธิผล ทำงานร่วมกันได้ ทนทาน และเชื่อถือได้เท่าที่ทำได้ในทางเทคนิค" (แปลโดย ReadEval) กฎหมายไม่ได้กำหนดว่าต้องใช้เทคโนโลยีใด
| วันที่ | เกิดอะไรขึ้น |
|---|---|
| ส.ค. 2024 | Wall Street Journal รายงานว่า OpenAI มีระบบลายน้ำข้อความที่เอกสารภายในเรียกว่า "มีประสิทธิผล 99.9%" แต่ยังไม่ปล่อย ส่วนหนึ่งเพราะผลสำรวจที่ผู้ใช้เกือบ 30% บอกว่าจะใช้ ChatGPT น้อยลง |
| 10 มิ.ย. 2026 | คณะกรรมาธิการยุโรปเผยแพร่ประมวลแนวปฏิบัติ (Code of Practice) เรื่องความโปร่งใสของเนื้อหาที่ AI สร้าง เป็นแนวทางแบบสมัครใจสำหรับทำตามมาตรา 50 ซึ่งให้ผู้ลงนามใช้หลายชั้นร่วมกัน เช่น ข้อมูลประกอบไฟล์ที่ลงลายมือชื่อดิจิทัลคู่กับลายน้ำที่มองไม่เห็น |
| 24 ก.ค. 2026 | กฎหมายแก้ไข AI Act (Digital Omnibus on AI) ลงราชกิจจานุเบกษาของ EU และมีผล 27 ก.ค. |
| 2 ส.ค. 2026 | หน้าที่ด้านความโปร่งใสตามมาตรา 50 เริ่มใช้บังคับ |
| 5 ต.ค. 2026 | OpenAI ประกาศ textGrain และเปิดให้ลูกค้า API ทั่วโลกเลือกเปิด |
| 2 ธ.ค. 2026 | เส้นตายทำเครื่องหมายสำหรับระบบที่วางตลาดใน EU ก่อน 2 ส.ค. 2026 |
TechCrunch รายงานว่า OpenAI เป็นหนึ่งในบริษัทที่ลงนามในประมวลแนวปฏิบัตินี้ ร่วมกับ Anthropic, Google, Meta และ Microsoft และสำนักงานกฎหมาย Morrison Foerster รายงานว่าคณะกรรมาธิการนับผู้ร่วมสนับสนุนได้ราว 190 องค์กรภายในปลายเดือนกรกฎาคม
เหตุที่ไม่เปิดทั่วโลก The Next Web รายงานว่า OpenAI ให้เหตุผลว่าการเริ่มเฉพาะภูมิภาคช่วยให้เรียนรู้จากการใช้งานจริงก่อน ReadEval ประเมินว่าช่วงเวลา "ไม่กี่สัปดาห์" ที่ OpenAI ประกาศสอดคล้องกับเส้นตาย 2 ธ.ค. สำหรับระบบที่อยู่ในตลาดอยู่แล้ว แต่ OpenAI ไม่ได้เชื่อมสองเรื่องนี้ให้เห็นตรง ๆ ในรายงานที่ ReadEval พบ
คนไทยเกี่ยวด้วยไหม
- ChatGPT ในไทย: ไม่อยู่ในรอบนี้ตามที่ OpenAI ประกาศ เพราะระบุเฉพาะผู้ใช้ในสหภาพยุโรป และ OpenAI บอกว่ายังไม่ใช่ค่าเริ่มต้นทั่วโลก
- แอปที่สร้างบน API ของ OpenAI: นักพัฒนาทุกประเทศเลือกเปิดลายน้ำให้โมเดลที่รองรับได้ ค่าเริ่มต้นปิด แปลว่าข้อความจากแอปหรือบริการของบริษัทไทยที่ใช้ OpenAI อาจมีหรือไม่มีลายน้ำก็ได้ ขึ้นกับผู้พัฒนา
- ยังไม่ยืนยัน: OpenAI ใช้อะไรตัดสินว่าใครเป็น "ผู้ใช้ในสหภาพยุโรป" (ตำแหน่งขณะใช้ หรือประเทศของบัญชี) ผู้ใช้ใน EU ปิดลายน้ำเองได้หรือไม่ และลายน้ำได้ผลแค่ไหนกับภาษาไทย ไม่มีแหล่งใดที่ ReadEval พบตอบเรื่องเหล่านี้
- AI ค่ายอื่น: Anthropic ประกาศเมื่อเดือนสิงหาคมว่าจะฝังลายน้ำในข้อความของ Claude ทั่วโลก โดยอิงจาก SynthID-Text ของ Google DeepMind เพราะ "ยังไม่มีวิธีที่มั่นคงในการจำกัดตามภูมิภาค" ตามที่ BleepingComputer รายงาน โมเดลใหม่จะมีลายน้ำ ส่วนโมเดลที่เปิดตัวก่อน 2 ส.ค. 2026 Anthropic บอกว่าจะทยอยเพิ่มในอีกหลายเดือน ส่วนเครื่องมือตรวจแบบ API ที่ Anthropic สัญญาไว้ ณ วันที่ BleepingComputer รายงาน (14 ส.ค. 2026) ยังไม่ได้บอกว่าจะเปิดเมื่อไร
- ตรวจเองได้ไหม: ยังไม่ได้ ตัวตรวจของ OpenAI เปิดรับใบสมัครจากนักวิจัยและองค์กรผู้เชี่ยวชาญ และพิจารณาเป็นรายกรณีภายใต้ประมวลแนวปฏิบัติของ EU ตามที่ The Next Web รายงาน OpenAI บอกว่าจะขยายสิทธิ์เมื่อแน่ใจว่าผลตรวจจะถูกตีความอย่างรับผิดชอบ
ถ้าคุณเป็นครู นักเรียน หรือคนทำงาน
- ครูและอาจารย์: อย่าใช้ผล "ไม่พบลายน้ำ" เป็นหลักฐานว่าเด็กเขียนเอง และอย่าใช้ผล "พบ" เป็นหลักฐานเดียวว่าโกง เพราะลายน้ำบอกไม่ได้ว่า AI ช่วยมากแค่ไหน ตัวตรวจของ OpenAI ก็ยังไม่เปิดให้โรงเรียนใช้ ReadEval ประเมินว่าเว็บหรือแอปที่อ้างว่าตรวจลายน้ำ ChatGPT ได้ในตอนนี้ไม่น่าจะใช้ตัวตรวจของ OpenAI เพราะยังไม่เปิดให้คนทั่วไป
- นักเรียนและคนทำงาน: ถ้าองค์กรหรือสถานศึกษาของคุณมีกติกาเรื่องการใช้ AI ให้ยึดกติกานั้นและบอกตรง ๆ ว่าใช้ AI ช่วยส่วนไหน การหวังพึ่ง "แก้คำนิดหน่อยให้ลายน้ำหาย" ไม่ใช่ทางออก เพราะกติกาไม่ได้ขึ้นกับว่าตรวจเจอหรือไม่
- คนที่ทำงานกับลูกค้าหรือหน่วยงานในยุโรป: ข้อความที่ร่างด้วย ChatGPT ใน EU จะทยอยมีลายน้ำ ถ้าเนื้อหานั้นเผยแพร่เพื่อแจ้งข้อมูลต่อสาธารณะ มาตรา 50 วรรค 4 ยังกำหนดหน้าที่เปิดเผยของผู้นำไปใช้แยกต่างหาก เว้นแต่ผ่านการตรวจหรือควบคุมเนื้อหาโดยคนที่รับผิดชอบการเผยแพร่
สื่อรายงานไม่ตรงกันตรงไหน
| ประเด็น | สิ่งที่พบ | ReadEval ถือตาม |
|---|---|---|
| หน่วยความยาวข้อความ | The Register เขียนว่าข้อความยาว 200 และ 400 "คำ" ขณะที่ BleepingComputer, The Next Web และ Techzine เขียนว่า "โทเค็น" | โทเค็น ตามที่สื่อส่วนใหญ่ซึ่งอ้างบล็อกของ OpenAI ระบุ |
| ตัวเลข 17% | The Register และ BleepingComputer เขียนว่าเป็นอัตราที่ตรวจพบเมื่อเปลี่ยนคำ 25% แต่ Techzine เขียนว่าเป็นสัญญาณที่เหลืออยู่ | อัตราที่ตรวจพบ ตามสองสำนักแรก และหมายเหตุไว้ใต้กราฟ |
| เปิดเป็นค่าเริ่มต้นใน EU ไหม | หัวข่าวบางแห่งเขียนว่า "เปิดเป็นค่าเริ่มต้น" แต่ถ้อยคำของ OpenAI ที่ BleepingComputer ยกมาคือ "จะเพิ่มลายน้ำในข้อความที่เข้าเกณฑ์" | ยังไม่ยืนยันว่าผู้ใช้ปิดเองได้หรือไม่ |
| ดีพอหรือไม่ | OpenAI บอกว่าทำได้เท่าหรือดีกว่าวิธีอื่นที่ทดสอบ แต่ The Register เรียกตัวตรวจว่า "พอใช้ได้อย่างหวุดหวิด" และ Techzine เรียกมาตรการนี้ว่าเป็นแค่ฉากหน้า | ทั้งสองฝ่ายพูดถึงคนละเรื่อง ฝ่ายแรกเทียบกับวิธีอื่น ฝ่ายหลังเทียบกับการใช้งานจริง |
ตามเกณฑ์ความน่าเชื่อถือของ ReadEval ตัวเลขอัตราตรวจเจอชุดนี้อยู่ในระดับ "คำกล่าวอ้างของผู้พัฒนา" เพราะ OpenAI วัดเอง ตัวตรวจและรหัสลับยังไม่เปิดให้คนอื่นทดสอบซ้ำ และไม่มีผู้ทดสอบอิสระ ข้อที่ผ่านคือ OpenAI บอกข้อจำกัดไว้ชัด และตัวเลขที่ออกมาก็เปิดเผยจุดอ่อนของตัวเอง ไม่ได้มีแต่ด้านดี
บทวิเคราะห์จาก ReadEval
Rea · โต๊ะข่าว AI
ลายน้ำข้อความของ OpenAI คือป้ายบอกที่มาแบบลบได้ ไม่ใช่เครื่องจับโกง และควรถูกใช้แบบนั้น
ลายน้ำที่ซ่อนในการเลือกคำเป็นความคิดที่ฉลาด เพราะติดไปกับข้อความทุกที่โดยไม่ทำให้อ่านยากขึ้น แต่ธรรมชาติเดียวกันก็ทำให้ลบง่าย ใครก็แก้คำได้ และ OpenAI ยอมรับเองว่าแก้แค่ 1 ใน 4 ของคำ ตัวตรวจก็แทบหาไม่เจอแล้ว ลายน้ำแบบนี้จึงช่วยได้มากที่สุดกับข้อความที่ถูกก๊อปไปใช้ทั้งก้อนโดยไม่มีใครแตะ เช่น บทความหรือโพสต์จำนวนมากที่ผลิตด้วย AI แล้วปล่อยออกไปตรง ๆ และช่วยได้น้อยกับคนที่ตั้งใจหลบ
จุดที่ ReadEval ห่วงคือการนำไปใช้ผิดทาง ถ้าวันหนึ่งตัวตรวจเปิดกว้างขึ้น ผล "เจอ" อาจถูกใช้ลงโทษคนที่แค่ให้ AI ช่วยเกลางาน ขณะที่ผล "ไม่เจอ" อาจถูกใช้รับรองงานที่ AI เขียนแล้วแก้คำนิดหน่อย OpenAI เองก็อ้างข้อจำกัดของลายน้ำเป็นเหตุผลที่จำกัดสิทธิ์ตัวตรวจไว้ก่อน โดยระบุว่า "ข้อจำกัดเหล่านี้เป็นส่วนหนึ่งที่ทำให้เราตัดสินใจเปิดตัวตรวจให้เฉพาะนักวิจัยที่ได้รับอนุมัติก่อน"
สำหรับผู้ใช้ในไทย วันนี้ยังไม่มีอะไรต้องทำ แต่ควรเข้าใจไว้ก่อนว่า เมื่อเครื่องมือแบบนี้มาถึง คำตอบของมันคือ "น่าจะ" ไม่ใช่ "แน่นอน" และการตัดสินเรื่องการใช้ AI ในงานเรียนหรืองานอาชีพ ยังต้องอาศัยกติกาที่ชัดและการพูดคุยกันตรง ๆ มากกว่าตัวตรวจใด ๆ
แหล่งที่มา
- TechCrunch: OpenAI will start watermarking ChatGPT's text in the EU (5 ต.ค. 2026)
- The Register: OpenAI rolls out weak-sauce watermarking for AI text (6 ต.ค. 2026)
- BleepingComputer: OpenAI is adding invisible watermarks to ChatGPT and Codex text in the EU (5 ต.ค. 2026)
- The Next Web: OpenAI starts watermarking ChatGPT and Codex text in the EU
- Techzine: OpenAI introduces AI watermark for texts in the EU (6 ต.ค. 2026)
- รายงานทางเทคนิค textGrain: Entropy-Calibrated Watermarking for Language Model Text (University of Pennsylvania, Yale University, OpenAI, 5 ต.ค. 2026)
- บล็อกของ OpenAI เรื่องลายน้ำข้อความใน EU (เว็บปฏิเสธการเข้าถึงของ ReadEval จึงอ้างผ่านสื่อ)
- European Commission AI Act Service Desk: Article 50 Transparency obligations
- EU Artificial Intelligence Act: Article 50 (ข้อยกเว้นและวรรค 4)
- Cuatrecasas: Code of Practice on Transparency of AI-Generated Content
- Garrigues: AI Digital Omnibus Regulation has been published, redefining deadlines
- Morrison Foerster: Full Transparency: Organizations Sign EU Code of Practice on AI Transparency (11 ก.ย. 2026)
- BleepingComputer: How Anthropic plans to watermark Claude's AI-generated text (14 ส.ค. 2026)
- Search Engine Journal: OpenAI scraps ChatGPT watermarking plans (5 ส.ค. 2024 อ้างรายงานของ Wall Street Journal)
- Wikimedia Commons: OpenAI logo 2025 (symbol)